
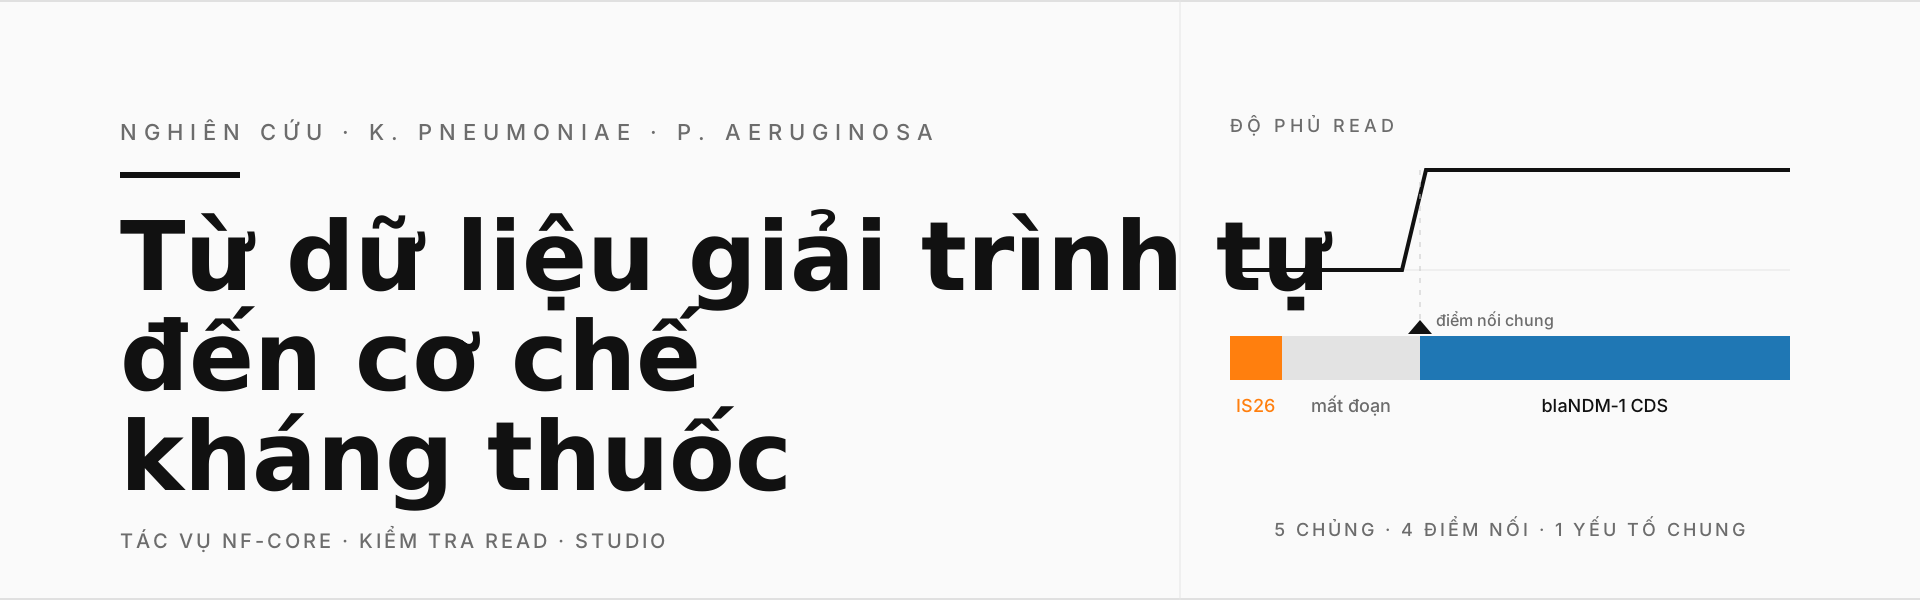
Từ dữ liệu giải trình tự đến cơ chế kháng thuốc ở Klebsiella pneumoniae và Pseudomonas aeruginosa
Câu chuyện nghiên cứu trước, chi tiết kỹ thuật sau. Nửa đầu bài viết kể câu chuyện nghiên cứu — câu hỏi, kết quả và ý nghĩa — bằng ngôn ngữ dễ hiểu. Nửa sau dành cho các nhà bioinformatics muốn tái lập phân tích. Phần nền tảng nằm ở hai bài đồng hành: Cách chạy pipeline nf-core trên nền tảng Omicslab và Hướng dẫn xây dựng bộ genome vi khuẩn không cần lập trình.
Câu hỏi nghiên cứu
Một số chủng Klebsiella pneumoniae và Pseudomonas aeruginosa mang blaNDM, nhưng lại nhạy cảm với ceftazidime–avibactam (CAZ-AVI).
Liệu bộ lắp ráp hệ gen có giải thích được kết quả tưởng như mâu thuẫn này không?
Dữ liệu đến từ Dung và cộng sự (2025), nhóm tác giả báo cáo các chủng này trong một nhóm bệnh nhân nhiễm khuẩn hô hấp dưới tại Việt Nam. Một số gene blaNDM trông như bị cắt cụt trong bộ lắp ráp hệ gen — một lời giải thích hợp lý cho việc vẫn nhạy cảm — dựa trên bộ lắp ráp đọc ngắn cùng BLASTn. Cả năm lần chạy đều công khai trong dự án ENA PRJEB86571: bốn chủng K. pneumoniae và một chủng P. aeruginosa. Chúng tôi tái dựng chúng từ read thô và kiểm tra gene này đến từng base.
Cách tiếp cận
Omicslab tái dựng các bộ dữ liệu công khai và kết hợp:
- Lắp ráp hệ gen — dựng lại từng chủng từ read thô bằng
nf-core/bacass. - Phát hiện gene kháng thuốc — thống kê gene kháng kháng sinh và vị trí trên contig bằng AMRFinderPlus.
- Phân tích plasmid — tái dựng và định type plasmid bằng MOB-suite.
- Định type vi khuẩn — sequence type, type capsule và lipopolysaccharide bằng Kleborate.
- Kiểm tra ở mức read — đối chiếu
blaNDMtrực tiếp với read bằng một pipeline Nextflow tự viết. - Trực quan hóa — độ phủ, bản đồ điểm nối và bản đồ đoạn khuếch đại từ kết quả kiểm tra.
Toàn bộ chạy trên nền tảng Omicslab: các pipeline chuẩn dưới dạng tác vụ phân tích (Analysis jobs), phần phân tích tự viết và hình vẽ trong một phiên Studio code-server. Câu lệnh và phiên bản chính xác nằm ở phần chi tiết kỹ thuật.
Chúng tôi đã tìm thấy gì
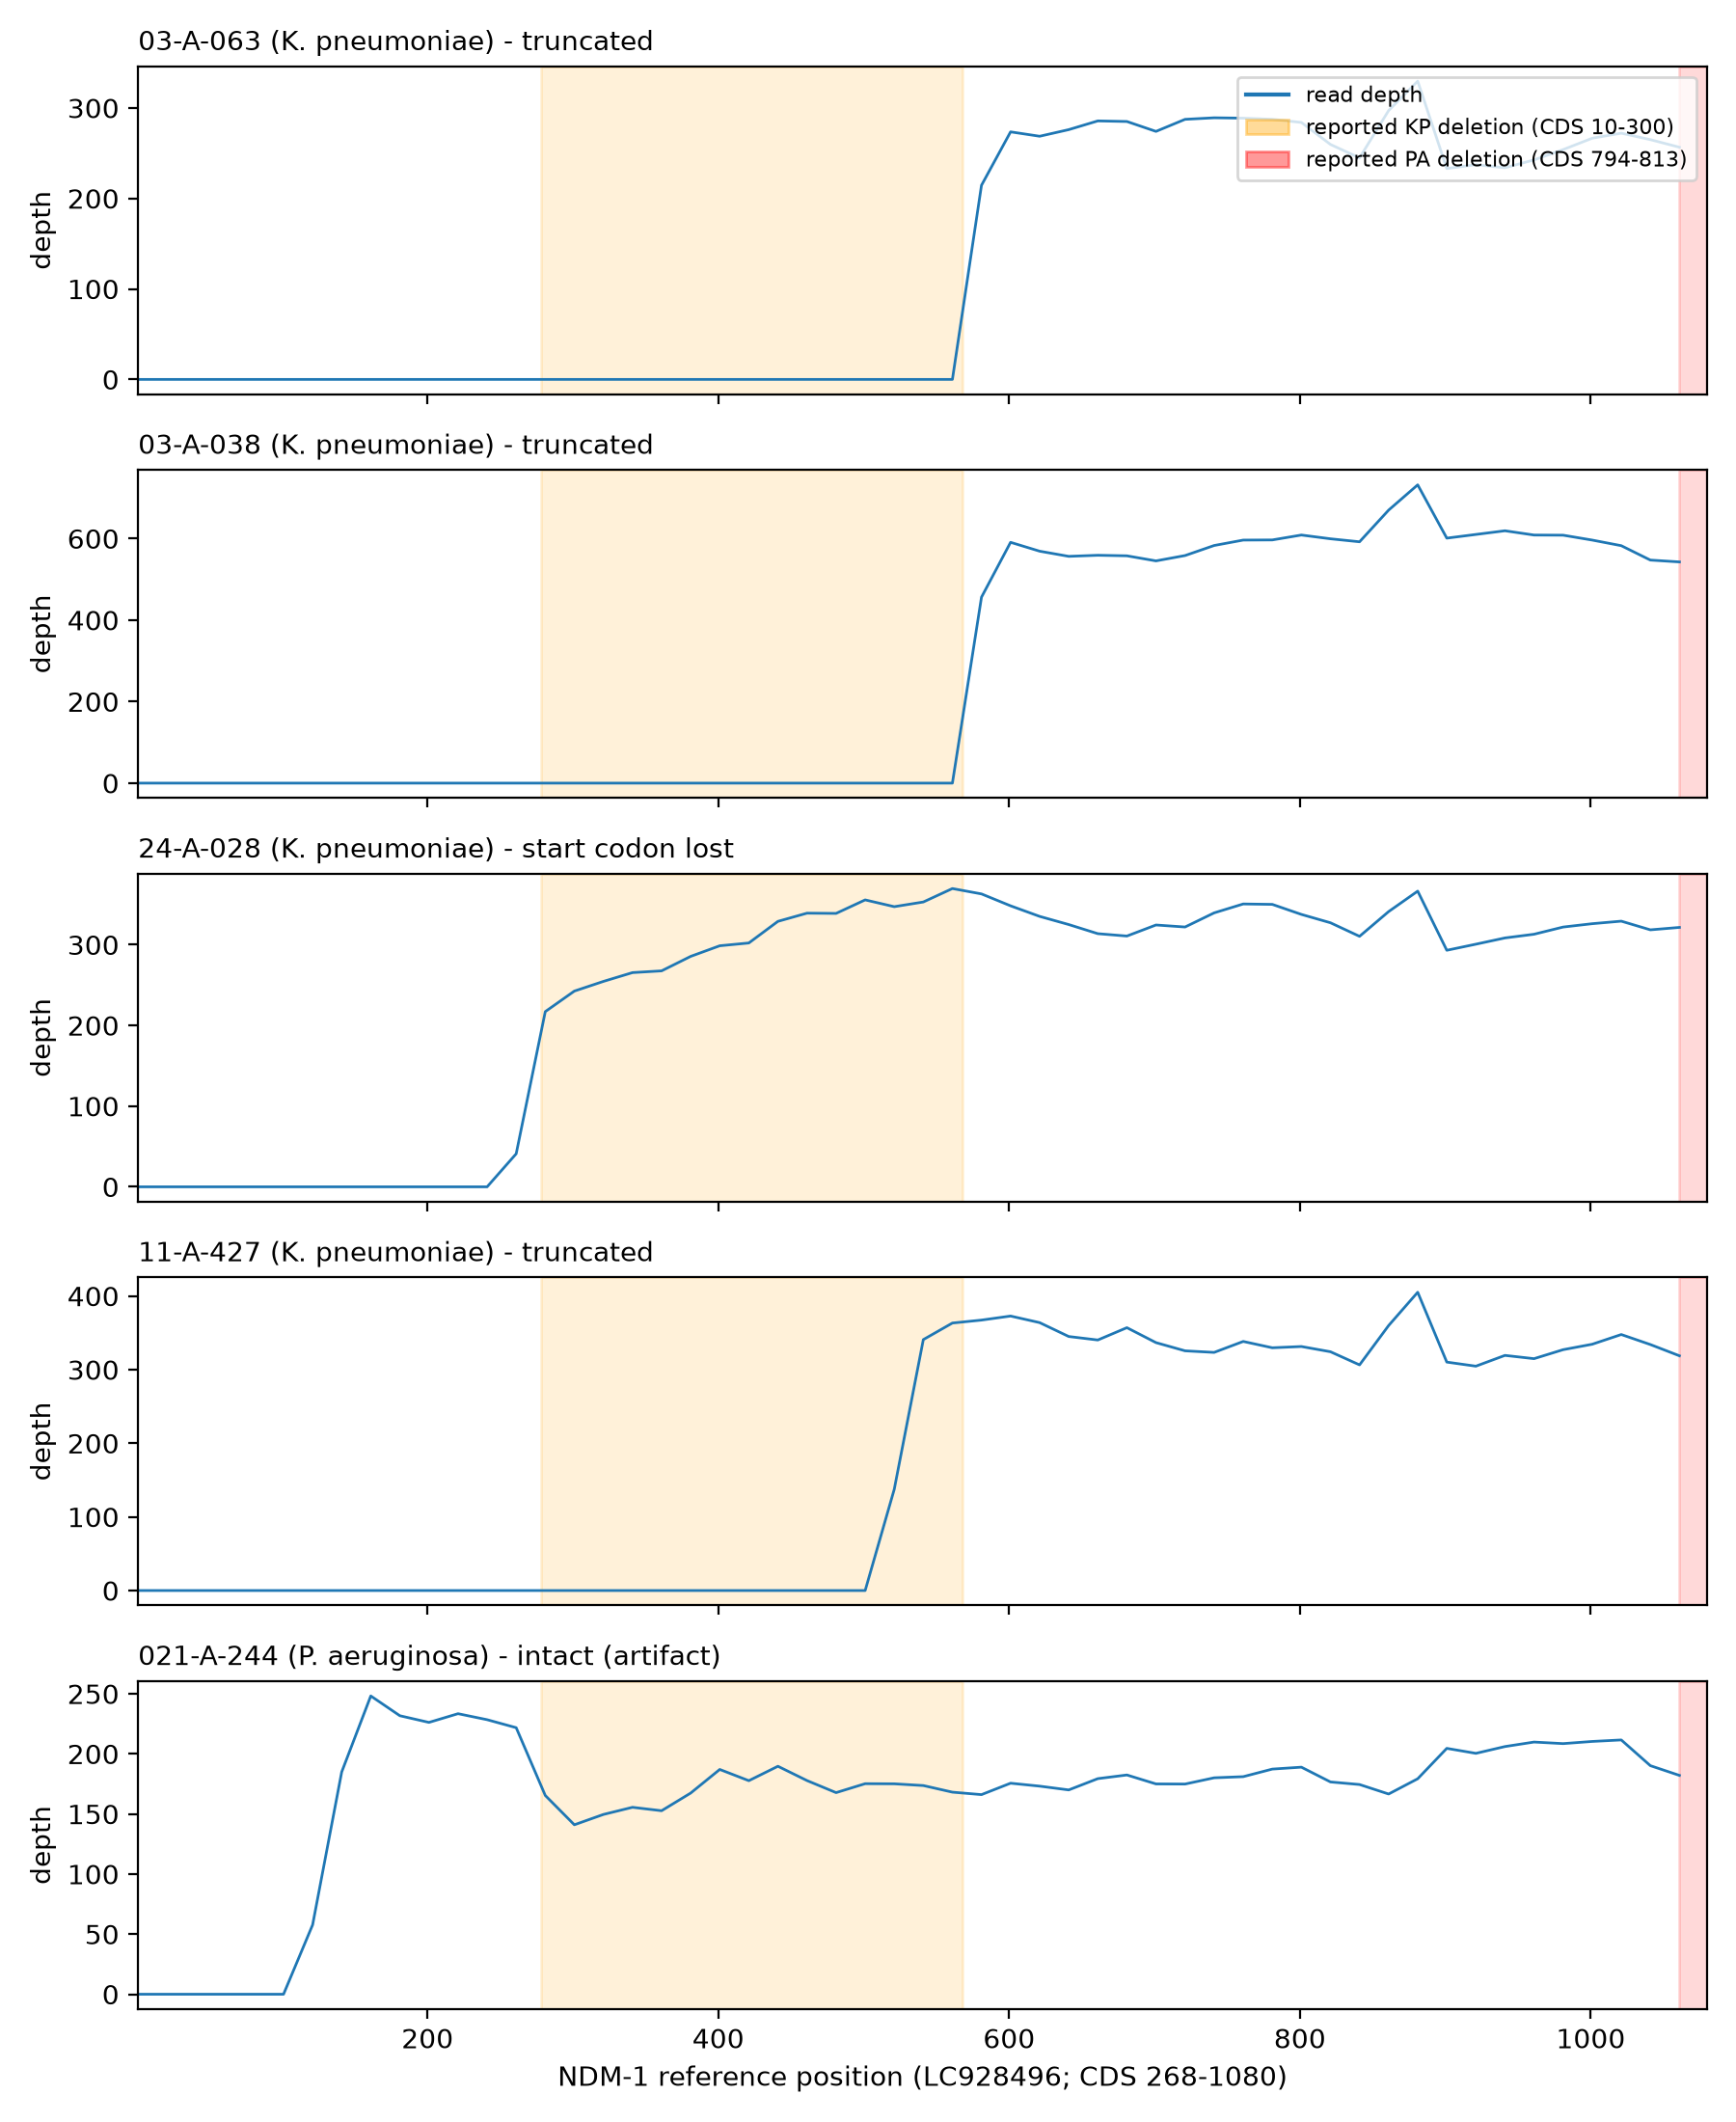
Hình 1 — Độ phủ read trên toàn bộ NDM-1 (tham chiếu LC928496) của năm chủng. Ba chủng K. pneumoniae có độ phủ bằng 0 trên vùng tô cam bên trái; một chủng chỉ mất đúng phần đầu của gene; chủng P. aeruginosa được phủ suốt cả gene.
Bộ lắp ráp gợi ý gene bị cắt cụt, nên chúng tôi quay lại với read thô để xác định liệu việc cắt cụt đó có được dữ liệu giải trình tự ủng hộ không.
Điều này quan trọng vì bộ lắp ráp là một cách diễn giải các read, không phải chính các read.
Ở mức read, kết quả chính vẫn đứng vững — và rõ hơn:
- Ở bốn chủng K. pneumoniae, một yếu tố di động họ IS26 chung nằm ở đầu 5′ của
blaNDM. Sự gián đoạn là thật, và trông như cùng một sự kiện di động ở bốn hậu duệ chứ không phải bốn lần mất gene độc lập. - Một trong bốn chủng giữ nguyên CDS nhưng chỉ mất codon mở đầu — yếu tố di động nối vào vị trí CDS 10.
- Cả bốn chủng thuộc dòng ST16 với hồ sơ plasmid gần như giống hệt nhau; tín hiệu họ OXA-48 được phân giải thành
blaOXA-181. - Ở chủng P. aeruginosa, read phủ mọi base của gene: ở mức read gene dài đầy đủ, và kết quả lắp ráp thiếu khớp với một ranh giới contig cắt vào đầu 5′ của gene.
- Đoạn khuếch đại của PCR NDM đang dùng nằm ngoài cả hai vùng mất đoạn, nên nó nguyên vẹn ở mọi allele — PCR dương tính không cho biết enzyme còn chức năng hay không.
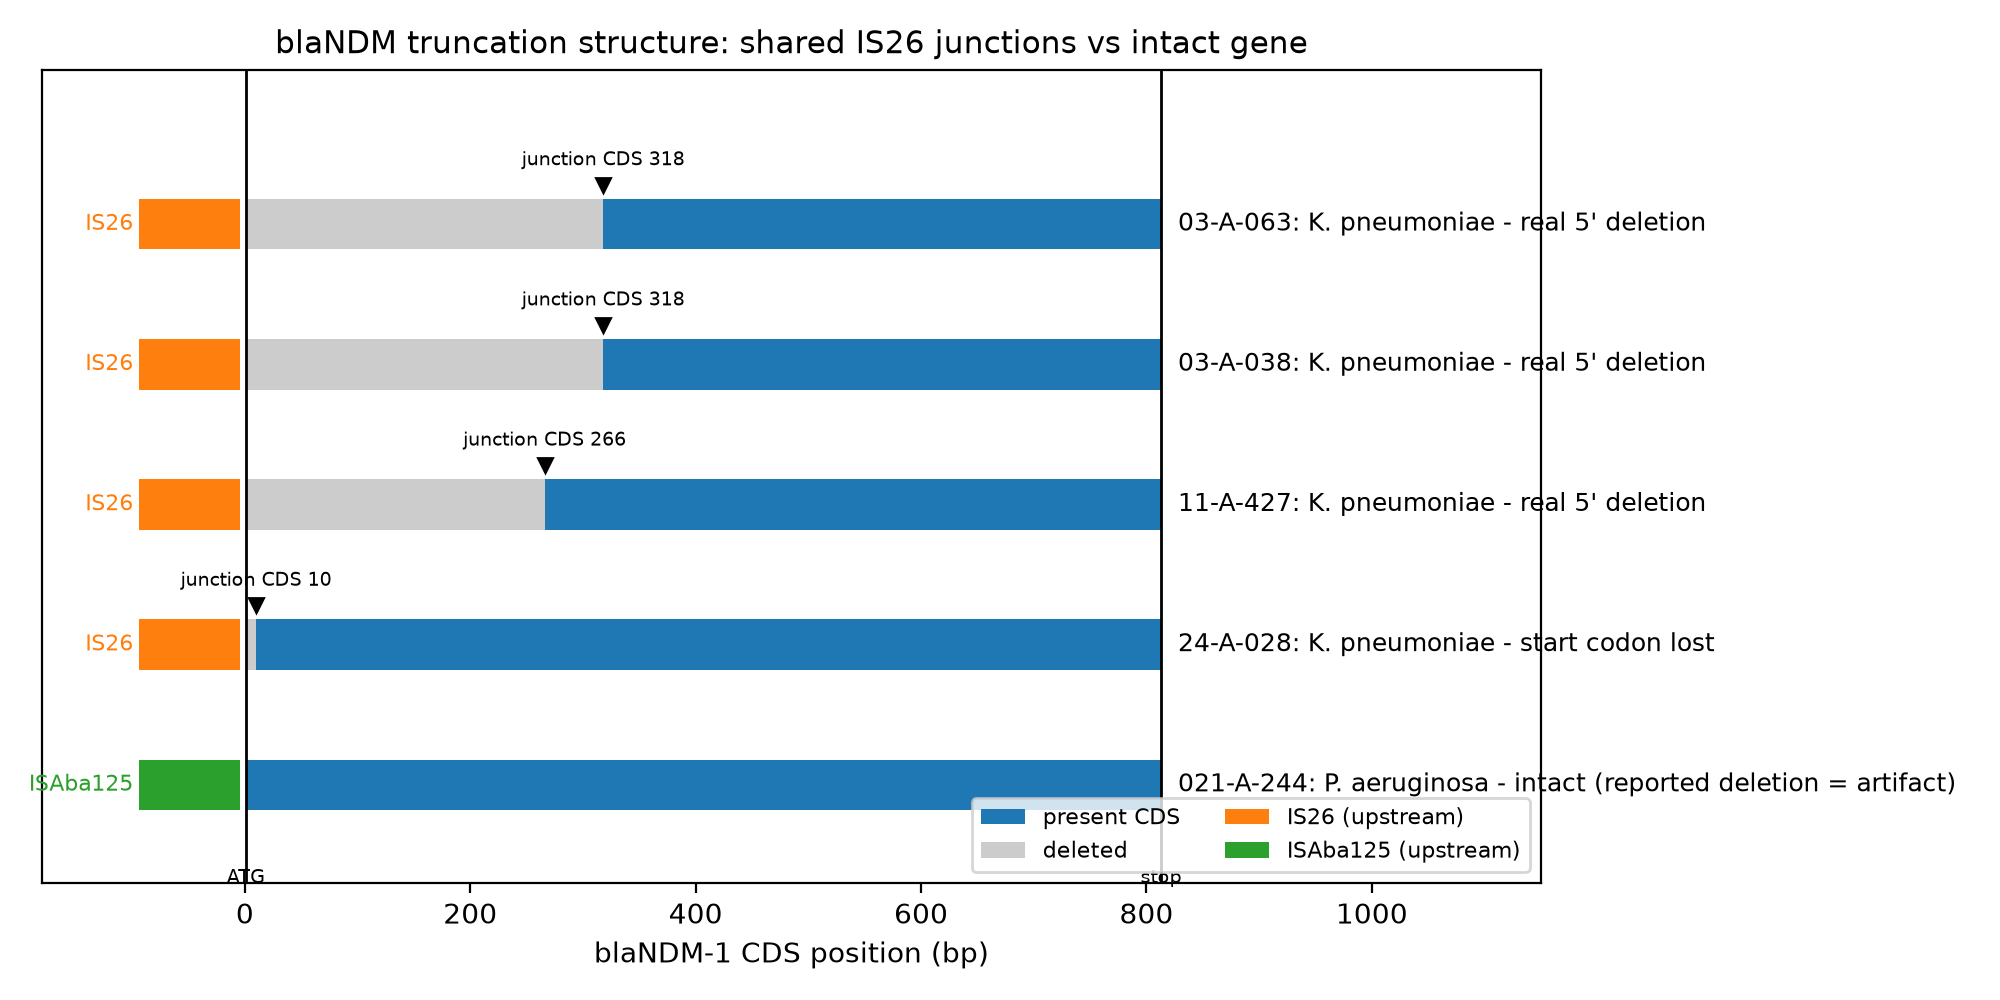
Hình 2 — Cấu trúc điểm nối. Ở bốn chủng K. pneumoniae, một yếu tố họ IS26 nằm ngay trước phần gene còn lại; ở chủng P. aeruginosa, ISAba125 nằm trước một CDS nguyên vẹn — đúng ngữ cảnh thường thấy của blaNDM.
Vì sao điều này quan trọng
Một gene kháng thuốc được gọi từ bộ lắp ráp nên được kiểm chứng ở mức read trong một số trường hợp, đặc biệt khi ngữ cảnh cấu trúc hoặc ranh giới lắp ráp có thể ảnh hưởng đến cách diễn giải.
Ở bộ dữ liệu này, lần kiểm tra mức read làm được ba việc: gọi tên cơ chế (một yếu tố họ IS26 ở đầu 5′), phân giải allele kháng thuốc (OXA-181, không chỉ là tín hiệu họ OXA-48), và cho thấy một gene bị đánh dấu là cắt cụt thực ra là hiệu ứng ranh giới contig. Về mặt lâm sàng, xét nghiệm phân tử và kết quả kháng sinh đồ cần đến nhau; chính các read giúp cặp kết quả đó luận giải được.
Điều này có nghĩa gì với các nhà nghiên cứu
Cùng một quy trình có thể hỗ trợ:
- Nghiên cứu kháng kháng sinh — nối kiểu gene kháng thuốc với kiểu hình quan sát được.
- Đặc trưng hệ gen vi khuẩn — lắp ráp, chú giải và định type các chủng quan tâm.
- Giám sát hệ gen — theo dõi dòng vi khuẩn và yếu tố di động qua các ca bệnh và thời gian.
- Điều tra bùng phát — kiểm tra các ca bệnh có chung một chủng hay plasmid không.
- Nghiên cứu cơ chế kháng thuốc — làm rõ một gene bị gián đoạn, tiếp nhận hay bị im lặng như thế nào.
Omicslab hỗ trợ phân tích này như thế nào
Pipeline chuẩn + phân tích tự viết + hạ tầng tính toán mở rộng + môi trường tái lập, trong cùng một chỗ:
- Pipeline chuẩn.
nf-core/fetchngsvànf-core/bacasschạy như các tác vụ phân tích — công cụ trong kho, tham số trên biểu mẫu, log, ước tính chi phí và kết quả ngay trên trình duyệt. - Phân tích tự viết. Phần kiểm tra mức read và các công cụ typing chạy thẳng từ kho Git của dự án, trong terminal Studio.
- Tính toán mở rộng. Các mẫu được xếp chạy song song trên CloudFly, GreenNode hoặc cụm Slurm của bạn, ngay cạnh vùng lưu trữ.
- Môi trường tái lập. Môi trường
pixighim phiên bản bằngpixi.lock; mỗi job giữ một manifest gồm phiên bản và tham số, sẵn sàng chạy lại.
Muốn xem nhanh những gì job trong Analysis và Studio có thể làm? Video demo dưới đây đi qua từng bước.
Video — những gì bạn có thể làm với job trong Analysis và Studio trên nền tảng Omicslab.
Mới làm quen với nền tảng? Hai bài đồng hành hướng dẫn từng bước: Cách chạy pipeline nf-core trên nền tảng Omicslab và Hướng dẫn xây dựng bộ genome vi khuẩn không cần lập trình.
Chi tiết kỹ thuật
Dành cho các nhà bioinformatics muốn tái lập phân tích. Mọi thứ dưới đây đều công khai — không cần dữ liệu riêng.
Dữ liệu và kho mã
- Reads: dự án ENA PRJEB86571 —
ERR14693661đếnERR14693665(bốn chủng K. pneumoniae, một chủng P. aeruginosa). - Mã nguồn, tham số và hình vẽ: vieomics/solutions, nhánh
topic/ndm-truncation.
Mọi thứ phân tích cần đều nằm trong kho mã đó. Bạn không cần đọc hết, nhưng một vòng hai phút sẽ giúp các bước dưới dễ theo hơn:
solutions/├── README.md # hướng dẫn cài đặt và chạy├── ids.csv # năm mã truy cập ENA (PRJEB86571)├── bacass_samplesheet.tsv # mỗi dòng một chủng; đầu vào của nf-core/bacass├── pixi.toml # môi trường và tác vụ pixi├── pixi.lock # phiên bản ghim của mọi công cụ├── params/│ └── bacass.json # tham số bacass và vị trí database├── conf/│ ├── fetchngs.config # cấu hình tải lại / chống throttle│ └── resources.config # chính sách CPU:RAM cho các lần chạy├── analysis/│ ├── ndm_audit.nf # pipeline kiểm tra mức read (Nextflow)│ └── ndm_audit_samplesheet.tsv # chủng + đường dẫn FASTQ cho phần kiểm tra├── bin/│ ├── fetchngs_to_bacass.py # chuyển samplesheet fetchngs cho bacass│ ├── ndm_audit_summary.py # tổng hợp độ phủ / read bắc qua / mất đoạn│ ├── assembly_analysis.sh # AMRFinderPlus, MOB-suite, Kleborate, ngữ cảnh IS│ └── plot_*.py # bốn script vẽ hình├── docs/│ ├── blog.md # bản viết│ └── figures/ # hình kết quả (PNG + SVG)└── results/, work/, logs/ # sinh ra khi chạy (không đưa vào git)Cách đọc:
- Tệp đầu vào ở thư mục gốc —
ids.csv(tải gì) vàbacass_samplesheet.tsv(lắp ráp gì). Đây là hai tệp bạn chạm vào đầu tiên. pixi.toml+pixi.lock— các môi trường dùng xuyên suốt:default(Nextflow + Apptainer),analysis(AMRFinderPlus, MOB-suite, Kleborate, bwa, samtools…) vàplots(matplotlib). Tệp lock là thứ khiến chuỗi công cụ tái lập được.params/vàconf/— các nút vặn: tham số pipeline cùng cấu hình tài nguyên và tải dữ liệu cho cụm.analysis/vàbin/— phần code tự viết. Pipeline Nextflow làm phần kiểm tra mức read; các script Python và shell chuyển samplesheet, tổng hợp kết quả và vẽ hình.docs/— bản viết và hình, gồm bốn hình dùng trong bài này.results/,work/,logs/— được tạo khi bạn chạy; không bao giờ được commit: kho mã giữ code và đầu vào, không giữ kết quả.
Pipeline, phiên bản và tài nguyên
| Thành phần | Nhiệm vụ | Phiên bản / cấu hình |
|---|---|---|
nf-core/fetchngs |
tải các run công khai, kiểm tra MD5 | 1.13.0 |
nf-core/bacass |
lắp ráp đọc ngắn (Unicycler) | 2.6.1 |
analysis/ndm_audit.nf |
kiểm tra blaNDM ở mức read |
Nextflow tự viết |
| Môi trường pixi | default (Nextflow + Apptainer), analysis (công cụ typing), plots (matplotlib) |
ghim bằng pixi.lock |
conf/resources.config |
chính sách CPU cho cụm | 2 GB mỗi CPU; process_medium ở 16 CPU / 32 GB |
Bước 1 — Tải reads bằng nf-core/fetchngs
Đầu vào duy nhất là một danh sách mã truy cập (ids.csv):
ERR14693661ERR14693662ERR14693663ERR14693664ERR14693665Trên nền tảng, chọn nf-core/fetchngs trong kho công cụ của workspace, trỏ input vào tệp rồi chạy như một tác vụ phân tích. Câu lệnh tương đương, nếu bạn muốn tự chạy với môi trường pixi của kho mã:
pixi run fetchngs# tương đương:pixi run nextflow run nf-core/fetchngs -r 1.13.0 -profile apptainer \ --download_method sratools --input ids.csv --outdir results/fetchngs -resumeHai ghi chú kỹ thuật nhỏ từ lần chạy:
- Dữ liệu được tải qua gương NCBI SRA (
sratools) vì gương ENA bị bóp băng thông xuống dưới 1 MB/s và hay đứng ở các node tính toán; đường SRA đo được khoảng 10 MB/s. fetchngskiểm tra các tệp FASTQ bằng MD5, nên một lần chạy báo thành công nghĩa là dữ liệu nguyên vẹn.
Kết quả là năm bộ read cùng một tệp samplesheet.csv sẵn sàng cho pipeline kế tiếp.
Bước 2 — Lắp ráp hệ gen bằng nf-core/bacass
nf-core/bacass nhận samplesheet, lắp ráp bằng Unicycler và chú giải nếu cần. Trên nền tảng, đây là tác vụ phân tích thứ hai; kho mã giữ tham số trong params/bacass.json và ghim phiên bản pipeline (2.6.1), nên nhiều năm sau vẫn có thể chạy lại với đúng đầu vào đó.
pixi run bacass# tương đương:pixi run nextflow run nf-core/bacass -r 2.6.1 -profile apptainer \ -c conf/resources.config -params-file params/bacass.json -resumeNăm bộ dữ liệu đọc ngắn nằm gọn trong một job, các mẫu được xếp chạy song song trên hạ tầng bạn chọn.
Khi đã có bộ lắp ráp, một nhóm công cụ nhỏ và nhanh trả lời câu hỏi "chủng này chính xác là gì?". Chúng chạy trong một phiên Studio — tại terminal VS Code Server (code-server), với môi trường pixi analysis của kho mã:
- AMRFinderPlus — gọi gene kháng kháng sinh kèm vị trí trên contig.
- MOB-suite — tái dựng plasmid và định type replicon.
- Kleborate — sequence type của K. pneumoniae, type capsule và lipopolysaccharide, độc lực và kháng thuốc.
- Ngữ cảnh IS — vị trí các bản sao IS26 / ISAba125 so với gene (dùng trình tự từ ISfinder làm truy vấn).
- Đồng vị trí —
blaNDMvà gene họ OXA-48 có nằm trên cùng một contig không.
Bước 3 — Kiểm tra gene ở mức read
Bộ lắp ráp là một mô hình của hệ gen, không phải chính hệ gen. Có hai hành vi kinh điển của lắp ráp ảnh hưởng trực tiếp đến một kết luận "gene bị cắt cụt":
- gene nằm vắt qua ranh giới contig có thể bị lắp ráp ra ở dạng thiếu;
- các yếu tố di động lặp lại có thể bị gộp hoặc đặt nhầm chỗ, khiến khó biết bản sao nào mang cái gì.
Nên trước khi kết luận từ bộ lắp ráp, ta nên hỏi thẳng các read. Phần kiểm tra của chúng tôi ánh xạ toàn bộ read lên trình tự NDM-1 đầy đủ (LC928496) và đếm, cho từng chủng:
- độ phủ từng base trên khắp gene;
- số read bắc qua mỗi vùng được báo là mất đoạn;
- số read mang đột biến mất đoạn chồng lên vùng đó.
Bản thân pipeline (analysis/ndm_audit.nf) đủ nhỏ để đọc hết trong một lần. Nó nhận samplesheet (analysis/ndm_audit_samplesheet.tsv: mỗi dòng một chủng cùng đường dẫn R1/R2) và chạy một task cho mỗi chủng, nên cả năm chủng chạy song song. Mỗi task làm năm việc:
- Đánh index trình tự tham chiếu —
bwa indextrên trình tự NDM-1 đầy đủ (LC928496). - Ánh xạ reads —
bwa memánh xạ cặp FASTQ lên tham chiếu đó. - Sắp xếp và đánh index BAM —
samtools sortvàsamtools index, để các bước sau truy vấn nhanh. - Đo độ phủ —
samtools depth -aghi độ phủ tại từng vị trí của tham chiếu. - Tổng hợp — một script Python (
bin/ndm_audit_summary.py) đọc BAM và tệp độ phủ, ghi một dòng cho mỗi chủng: độ phủ trung bình trên CDS, độ phủ trung bình trên từng vùng được báo mất đoạn, số read bắc qua mỗi vùng, và số read mang đột biến mất đoạn tại đó.
Phần kiểm tra được thiết kế trung lập với giả thuyết. Bốn khả năng được đặt lên bàn cho mỗi chủng:
| Giả thuyết | Nghĩa là gì |
|---|---|
| H1 | Gene thật sự mất đoạn |
| H2 | Bộ lắp ráp thiếu chứ không phải gene (ranh giới contig hoặc độ phủ) |
| H3 | Tàn dư của yếu tố di động, hoặc một bản sao thứ hai im lặng |
| H4 | Gene nguyên vẹn nhưng không được biểu hiện (ví dụ promoter bị gián đoạn) |
Trên nền tảng, bạn có thể đăng ký pipeline như công cụ tự thêm bằng Git URL (Lược đồ phân tích & manifest), hoặc chỉ cần khởi chạy từ terminal trong một phiên Studio.
Kết quả ở mức read, chi tiết
| Chủng | Loài | Bức tranh ở mức read |
|---|---|---|
| 03-A-063 | K. pneumoniae | mất đoạn 5′; yếu tố họ IS26 nối vào vị trí CDS 318 |
| 03-A-038 | K. pneumoniae | mất đoạn 5′; yếu tố họ IS26 nối vào vị trí CDS 318 |
| 11-A-427 | K. pneumoniae | mất đoạn 5′; yếu tố họ IS26 nối vào vị trí CDS 266 |
| 24-A-028 | K. pneumoniae | CDS còn nguyên nhưng mất codon mở đầu (IS26 nối vào vị trí CDS 10) |
| 021-A-244 | P. aeruginosa | gene dài đầy đủ được read phủ khắp; kết quả lắp ráp thiếu khớp với ranh giới contig ở đầu 5′ của gene |
Kết quả là một tệp <chủng>.summary.tsv và một tệp .depth cho mỗi chủng trong results/ndm_audit/ — những con số đứng sau Hình 1 và Hình 4.
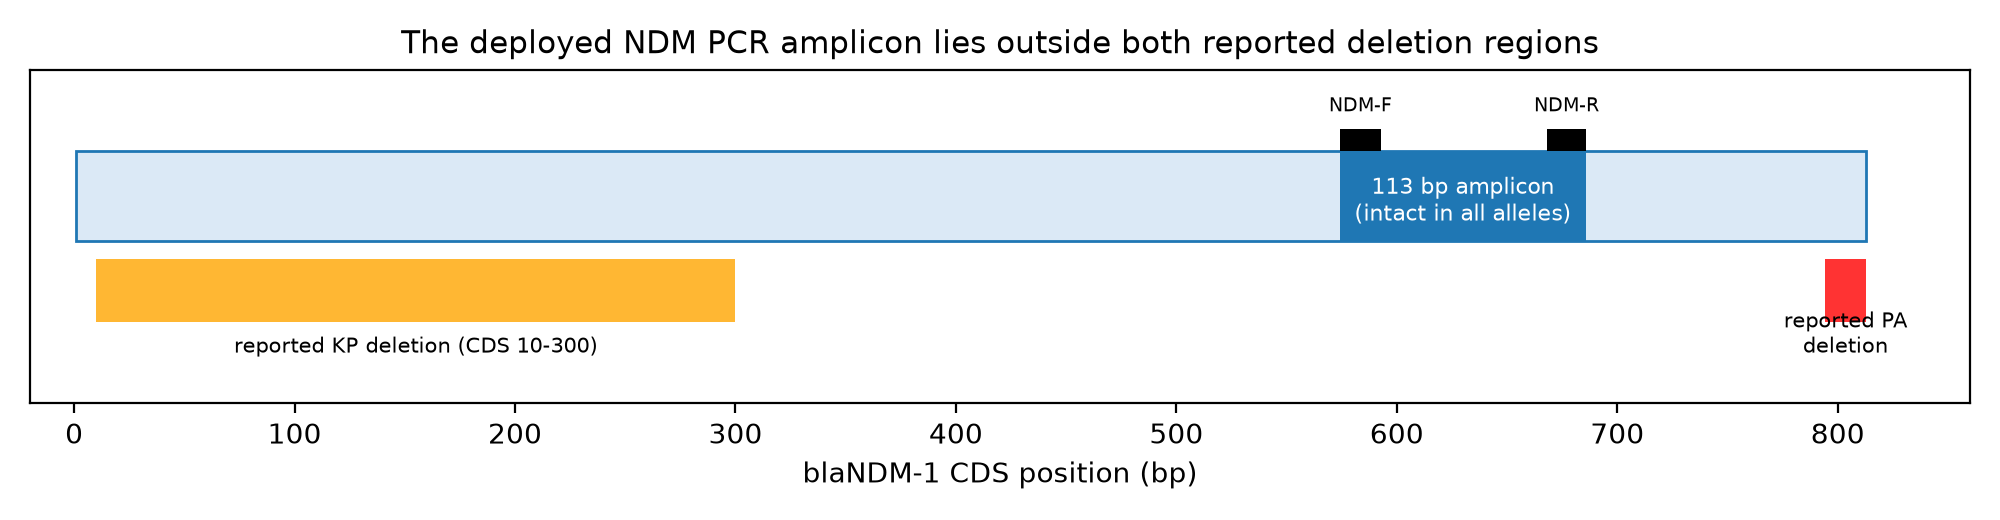
Hình 3 — Đoạn khuếch đại của PCR NDM đang dùng (CDS 574–686) nằm ngoài cả hai vùng được báo mất đoạn, nên nó nguyên vẹn ở mọi allele, dù gene có bị cắt cụt hay không.
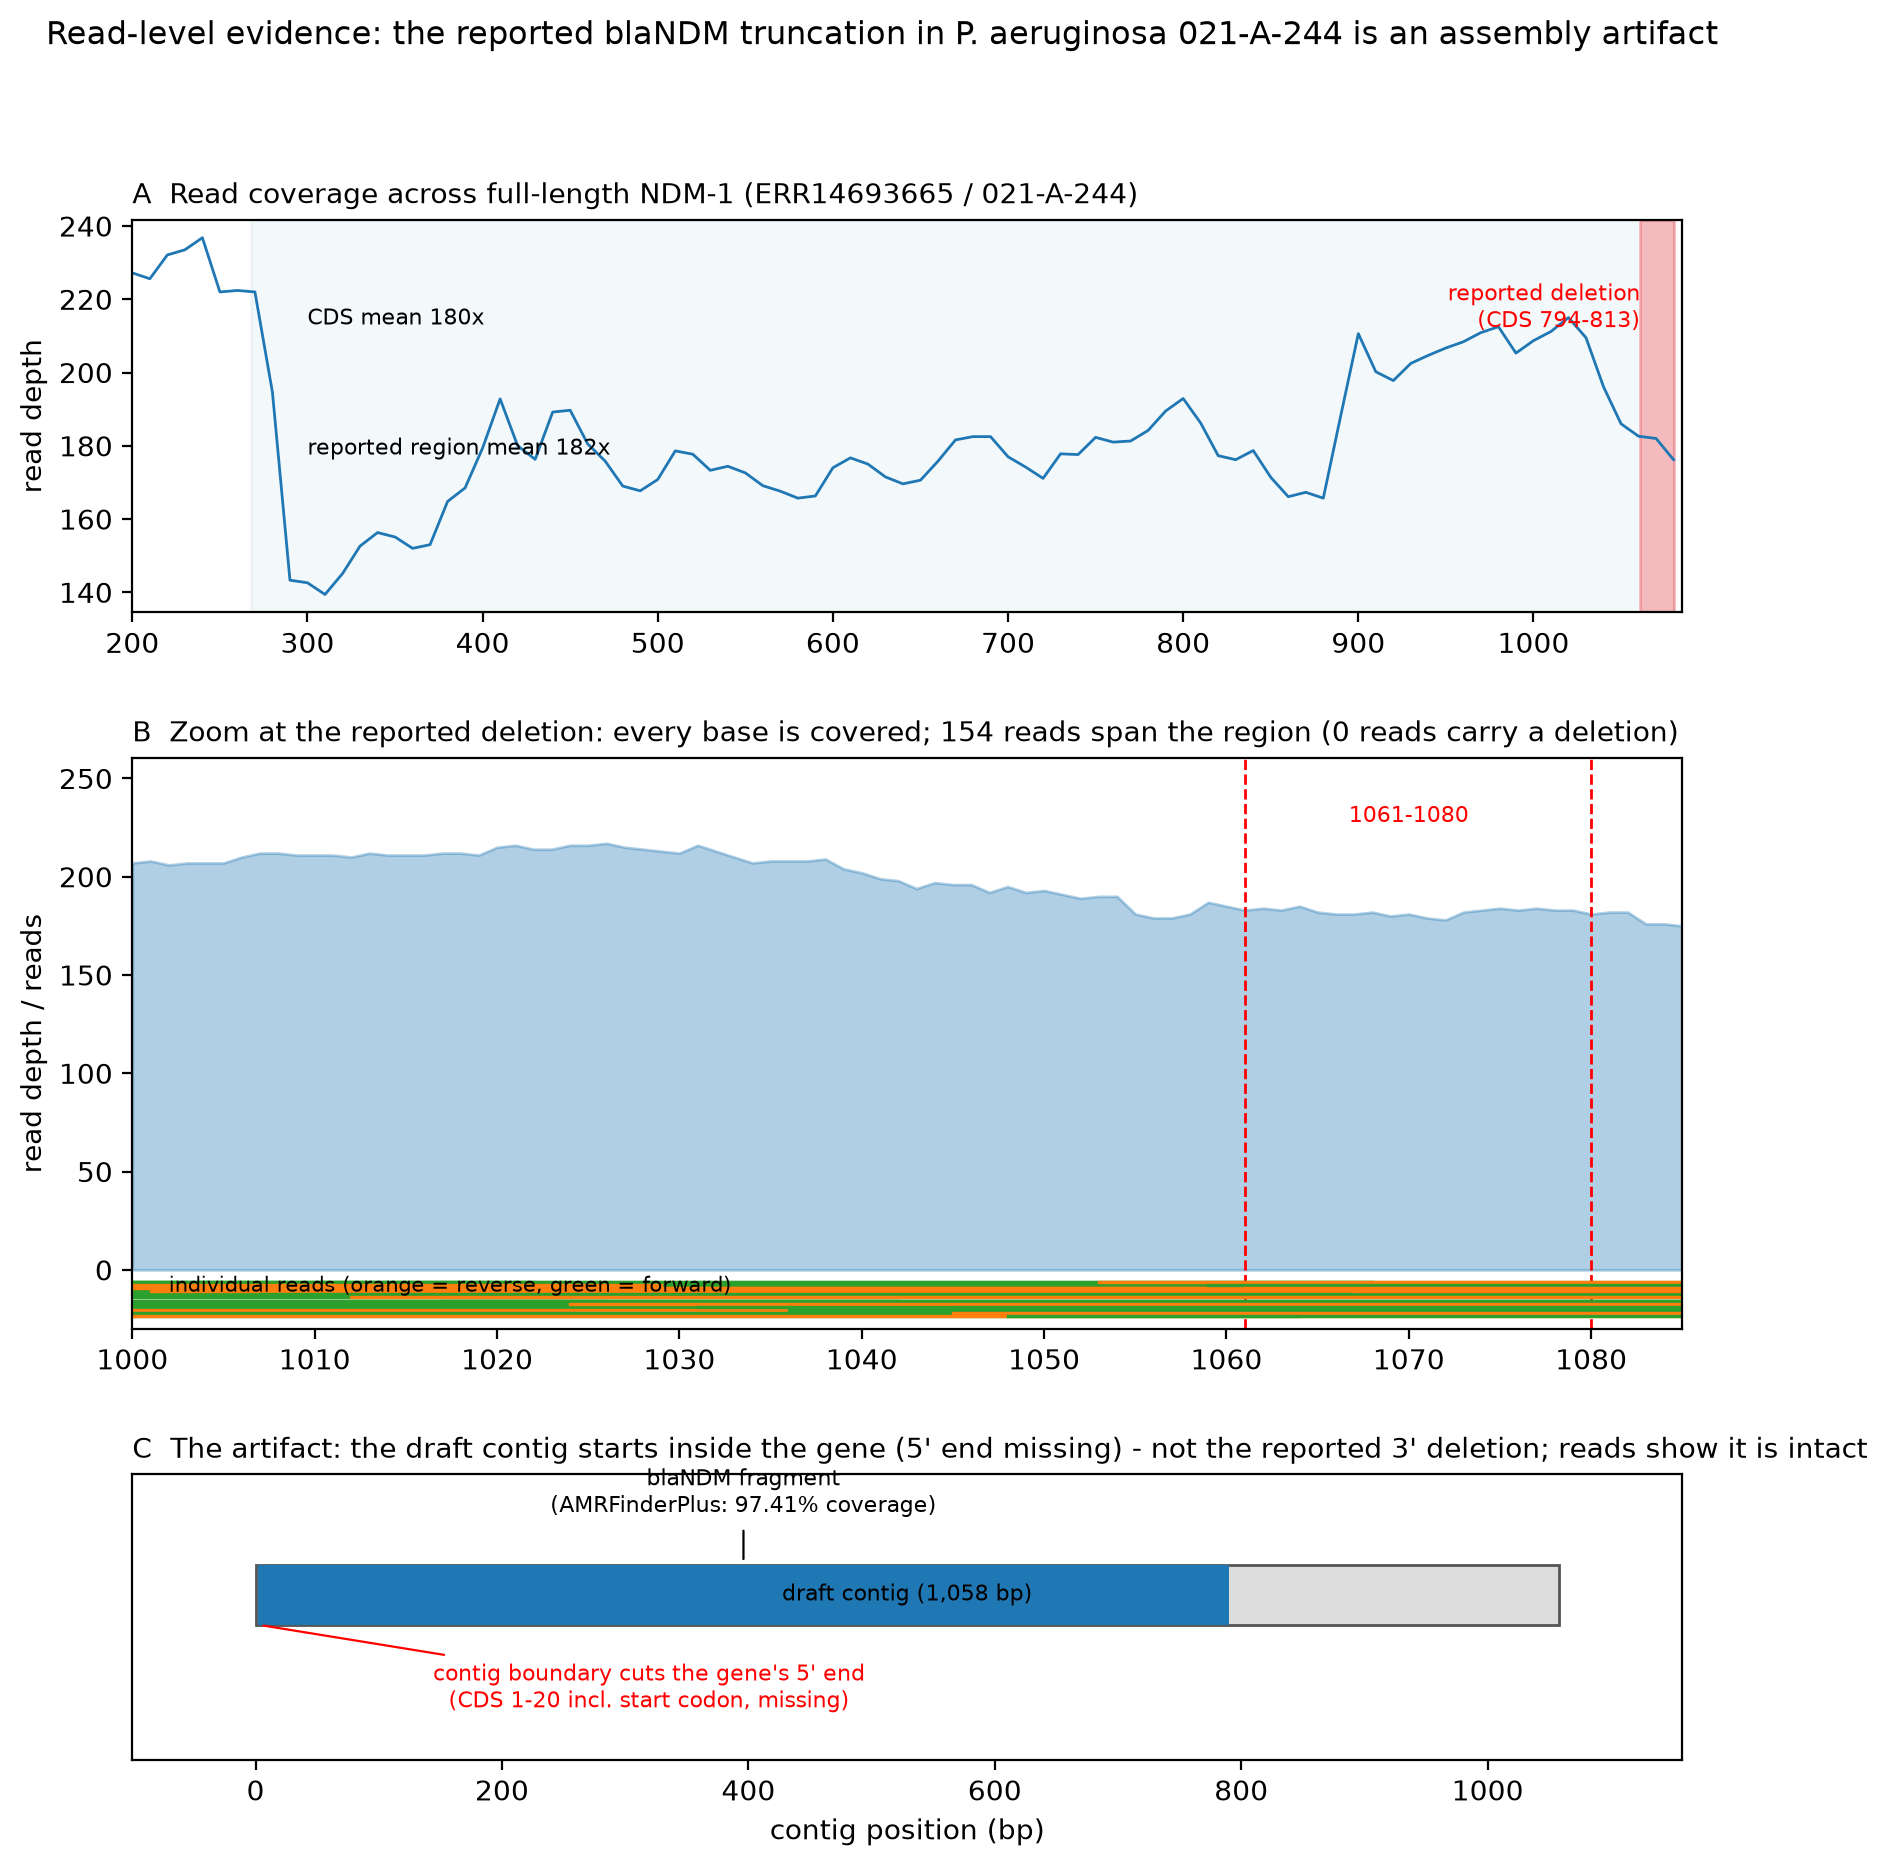
Hình 4 — Chủng P. aeruginosa (021-A-244): mọi base của gene đều được phủ (độ phủ trung bình khoảng 180×), 154 read bắc qua vùng được báo mất đoạn, và không read nào mang đột biến mất đoạn ở đó. Kết quả lắp ráp thiếu khớp với một ranh giới contig cắt vào đầu 5′ của gene.
Bước 4 — Khám phá và vẽ hình trong Studio
Mọi việc sau bước lắp ráp đều mang tính khám phá: mở một tệp độ phủ, xem một điểm nối, chỉnh một hình vẽ — kể cả các công cụ typing ở Bước 2. Mở một phiên VS Code Server (code-server) trong workspace, gắn kho mã vào, và mở terminal — toàn bộ chuỗi công cụ downstream chỉ cách một câu lệnh:
pixi install # tạo các môi trường đã ghim phiên bảnpixi run -e analysis # AMRFinderPlus, MOB-suite, Kleborate, bwa, samtools, BLAST, spades, ISEScan, seqkitpixi run -e plots # matplotlibRồi trong phiên đó:
pixi run -e analysis nextflow run analysis/ndm_audit.nf # kiểm tra ở mức readpixi run -e plots python3 bin/plot_coverage.py # Hình 1pixi run -e plots python3 bin/plot_pa_artifact.py # Hình 4pixi.toml và pixi.lock ghim các công cụ, nên môi trường hôm nay và sang năm vẫn như nhau. Không ai phải cài nửa phần mềm bioconda bằng tay, và dữ liệu không rời khỏi workspace: phiên chạy ngay cạnh vùng lưu trữ, thay vì trên một chiếc laptop có thể không có sẵn tệp. Khi phiên làm việc kết thúc, Snapshot lưu thư mục home của phiên trở lại workspace, để sau này tiếp tục đúng trạng thái đó (Phiên Studio).
Cùng những môi trường pixi đó chạy được trên máy cá nhân hoặc trên cụm Slurm của riêng bạn — pixi install đọc tệp lock và tái tạo chuỗi công cụ ở bất cứ đâu. Nền tảng không khóa bạn lại; nó chỉ đưa công việc lên trình duyệt và đến cạnh dữ liệu.
Kết quả đầu ra
results/fetchngs/— FASTQ đã tải và samplesheet của fetchngs.results/bacass/— bộ lắp ráp và kiểm định chất lượng.results/ndm_audit/— bảng tổng hợp (.summary.tsv) và tệp độ phủ (.depth) cho từng chủng.docs/figures/— bốn hình dùng trong bài này.work/,logs/— tệp làm việc và log của Nextflow (không đưa vào git).
Tài liệu tham khảo
- Dung và cộng sự (2025), Annals of Clinical Microbiology and Antimicrobials — doi.1186/s12941-025-00818-3
nf-core/fetchngs— nf-co.re/fetchngs;nf-core/bacass— nf-co.re/bacass- Tài liệu nền tảng — Tác vụ phân tích, Phiên Studio, Bắt đầu nhanh
- Video demo nền tảng — job trong Analysis và Studio: YouTube
- pixi — môi trường tái lập được: pixi.sh
- Công cụ — AMRFinderPlus, MOB-suite, Kleborate, ISfinder
Bài viết liên quan
- Hướng dẫn nền tảng: Cách chạy pipeline nf-core trên nền tảng Omicslab.
- Ví dụ trọn vẹn: Hướng dẫn xây dựng bộ genome vi khuẩn không cần lập trình.
- Thêm bài viết theo tag nf-core và platform.
- Tính năng và bảng giá tại trang Nền tảng Omicslab.
Bài viết gần đây
28 tháng 09, 2026
Hướng dẫn xây dựng bộ genome vi khuẩn không cần lập trình



4 tháng 05, 2026
Pipeline phân tích methyl hóa từ dữ liệu đọc ngắn với Nextflow

3 tháng 05, 2026