
Phần 2/5 — Làm thế nào một quốc gia xây dựng dự án 1000 Genomes của riêng mình? Nguyên tắc thiết kế và lộ trình triển khai
Ở Phần 1, chúng ta đã tìm hiểu vì sao mỗi quốc gia cần một dự án hệ gen riêng và kiến trúc tổng thể từ giải trình tự thô đến VCF cohort. Phần này đi vào các nguyên tắc thiết kế đảm bảo tính chuẩn hóa, khả năng mở rộng và quản trị dữ liệu — cùng lộ trình triển khai thực tế theo 5 giai đoạn.
Tổng quan chuỗi bài
- Phần 1: Tầm nhìn và kiến trúc tổng thể
- Phần 2 (bài này): Nguyên tắc thiết kế và lộ trình triển khai
- Phần 3: Gọi biến thể, phân tích cohort và tổ chức dữ liệu
- Phần 4: Hạ tầng, nhân lực và hỗ trợ của Chính phủ: 2018 → 2026
- Phần 5: Tóm tắt, mở rộng và những câu hỏi phía trước
1. Nguyên tắc thiết kế
1.1. Chuẩn hóa là nền tảng
Nếu không có tích hợp CI/CD, "chuẩn hóa" chỉ là một tuyên bố, không phải một bảo đảm.
- Không CI/CD = kiểm thử thủ công = kết quả không nhất quán giữa các nhà phát triển/môi trường
- Có CI/CD = kiểm thử tự động = kết quả giống nhau mỗi lần chạy, trên HPC hay cloud
Mỗi mẫu phải trải qua cùng một quy trình xử lý — đây là điều không thể thương lượng đối với phân tích quy mô quần thể.
Vì sao chuẩn hóa quan trọng:
- Khả năng tái lập: cùng dữ liệu đầu vào + cùng pipeline = cùng kết quả mỗi lần chạy
- Đảm bảo chất lượng: các vấn đề hệ thống được phát hiện sớm và xử lý đồng nhất trên mọi mẫu
- So sánh giữa các cohort: các lô và thời điểm khác nhau có thể được so sánh mà không bị sai lệch hệ thống
- Phân tích chung: thống kê toàn cohort chỉ hợp lệ khi mọi mẫu được xử lý giống hệt nhau
Triển khai:
- Dùng Nextflow để quản lý phiên bản pipeline và đảm bảo khả năng tái lập
- Định dạng gVCF bắt buộc đầu ra chuẩn hóa trên mọi mẫu
- Quản lý phiên bản (Github, Gitlab, Gitea, v.v.): theo dõi phiên bản pipeline, phiên bản hệ gen tham chiếu, phiên bản cơ sở dữ liệu chú giải
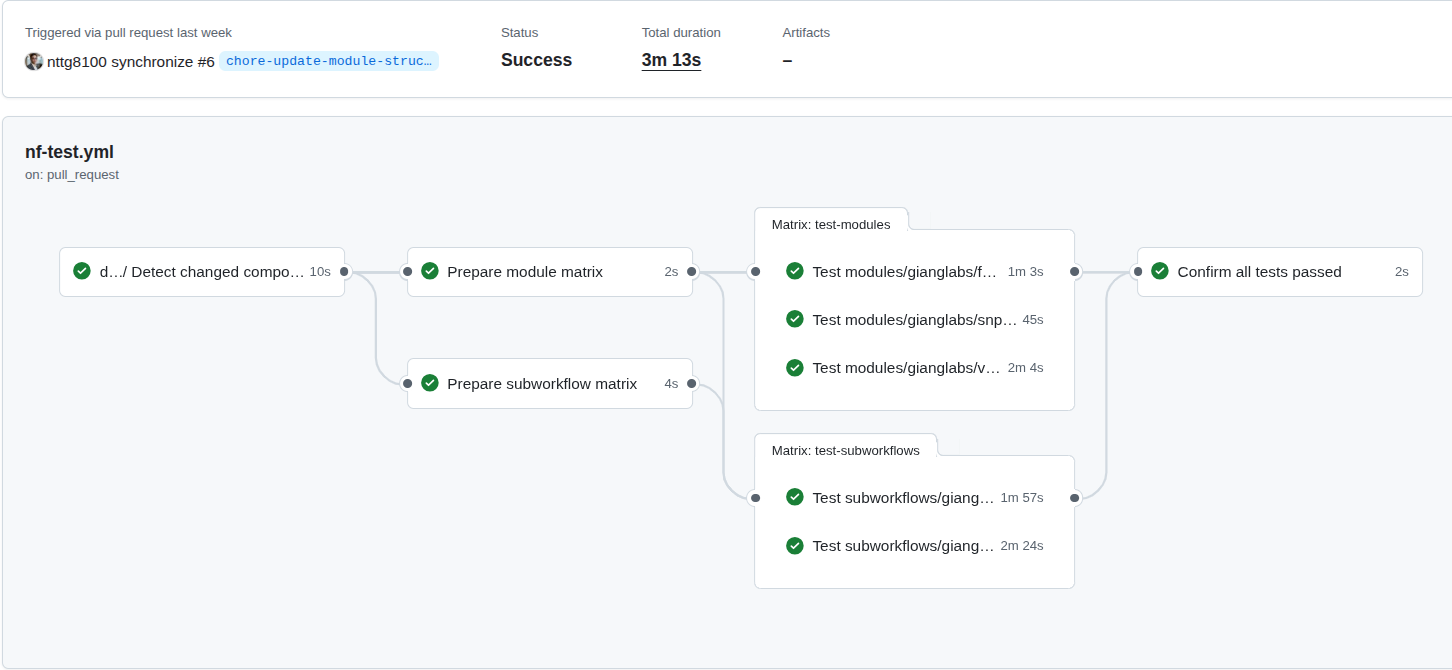
Hình 1: CI/CD cho nf-modules, cho thấy các mẫu chung (module, subworkflow) luôn giống hệt, có thể tái lập và tái sử dụng giữa nhiều pipeline.
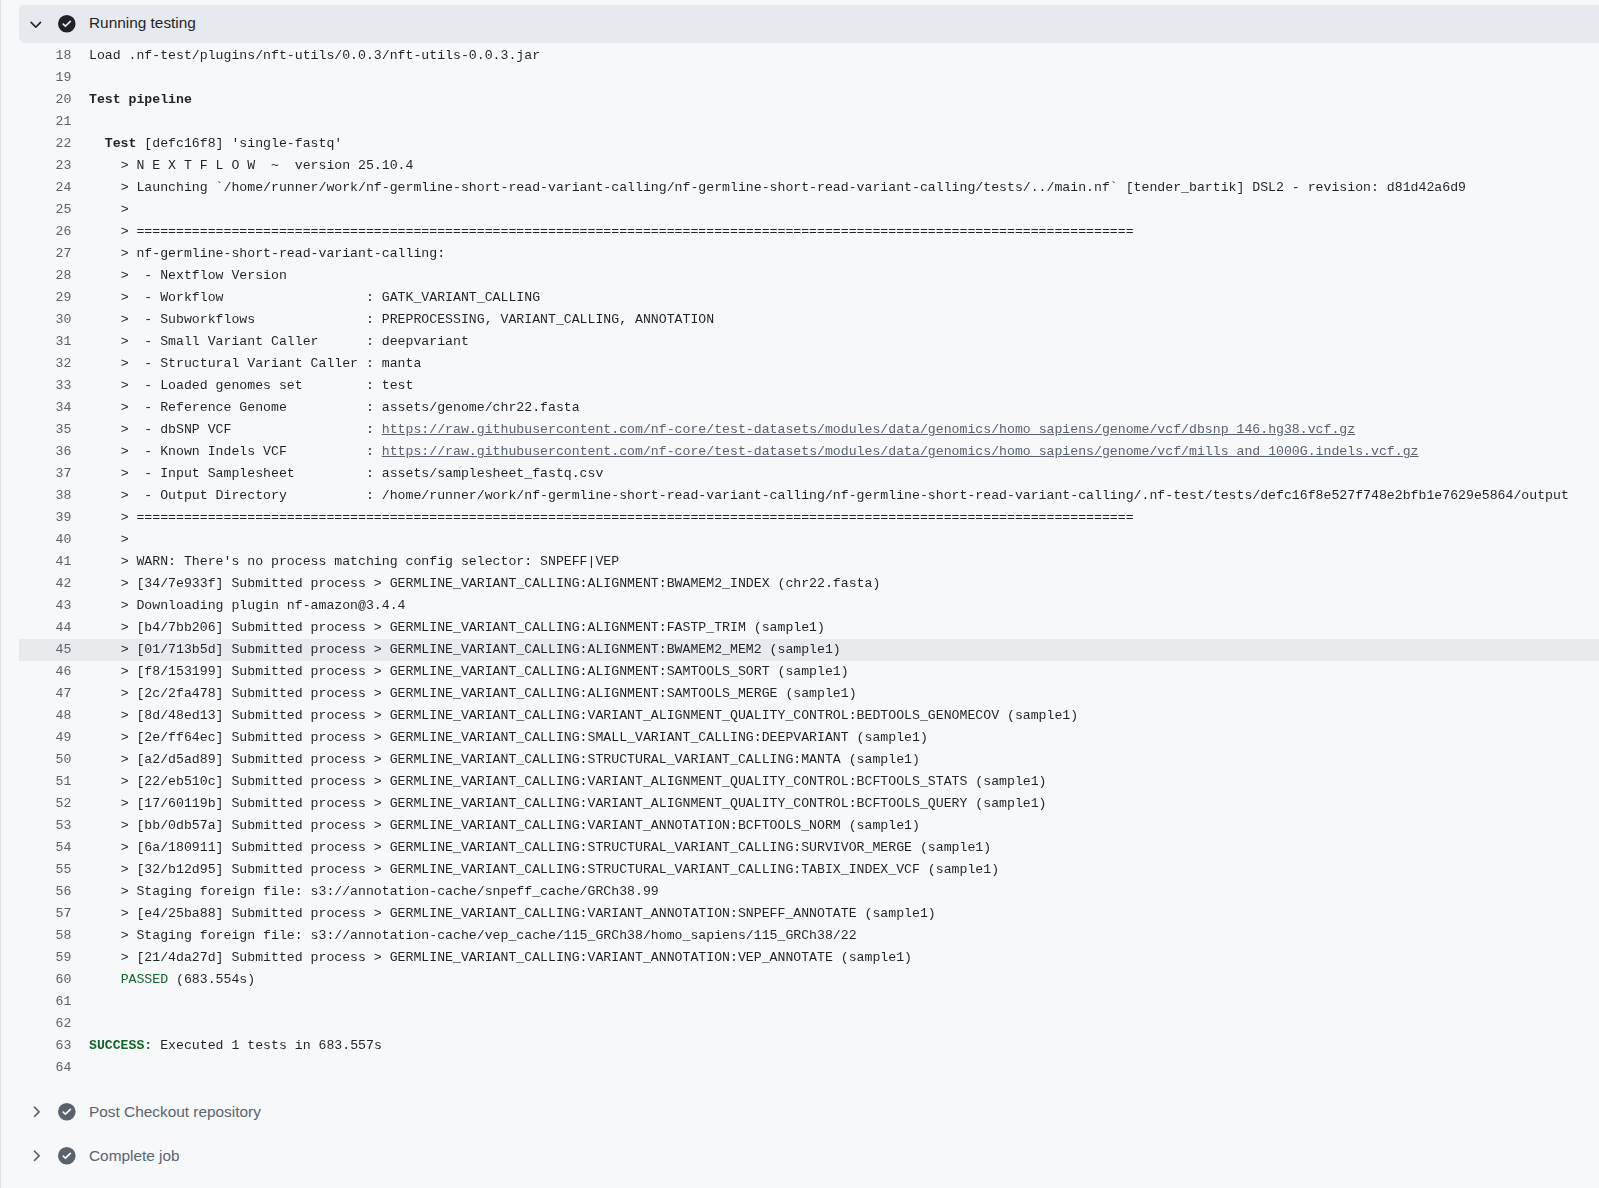
Hình 2: CI/CD cho nf-germline-short-read-variant-calling — cùng đầu vào tạo ra cùng đầu ra, và workflow có thể triển khai trên HPC hoặc cloud.
1.2. Khả năng mở rộng nhờ song song hóa theo vùng
Joint variant calling hoạt động trên toàn bộ cohort cùng lúc, không phải từng mẫu một. Chìa khóa để mở rộng là chia hệ gen thành các vùng (cửa sổ) nhỏ, độc lập rồi xử lý tất cả mẫu cùng nhau trong từng vùng, song song với nhau.
Chiến lược song song hóa:
- Tất cả mẫu trong mỗi vùng: với vùng 1, gọi biến thể trên TẤT CẢ mẫu cùng lúc; với vùng 2, gọi biến thể trên TẤT CẢ mẫu; v.v.
- Song song hóa theo vùng: mỗi vùng hệ gen chạy trên một job SLURM riêng, cho phép mở rộng theo chiều ngang
- Cô lập lỗi: nếu một vùng thất bại, bạn chỉ cần chạy lại vùng đó — không phải toàn bộ hệ gen cho tất cả mẫu
Chiến lược tệp BED (theo nhiễm sắc thể và theo khoảng):
Với cohort nhỏ đến trung bình (dưới 10k mẫu): dùng tệp BED đơn giản theo nhiễm sắc thể (mỗi nhiễm sắc thể một tệp):
- chr1.bed bao phủ chr1
- chr2.bed bao phủ chr2
- ... tương tự cho cả 22 nhiễm sắc thể thường
- chrX.bed và chrY.bed cho nhiễm sắc thể giới tính
Với cohort lớn (>10k mẫu): chia mỗi nhiễm sắc thể thành các khoảng 100kb để song song hóa mịn hơn:
- chr1_region_1.bed: chr1
- chr1_region_2.bed: chr1
- chr1_region_3.bed: chr1
- ... tiếp tục trên tất cả nhiễm sắc thể với hàng nghìn vùng
Vì sao cách tiếp cận theo khoảng này mở rộng tốt:
- Tiết kiệm bộ nhớ: mỗi vùng chỉ chứa khoảng 100kb dữ liệu hệ gen cho mỗi mẫu, không phải toàn bộ nhiễm sắc thể
- Song song hóa job: 22 nhiễm sắc thể × 24.000 khoảng = 528.000 job SLURM tiềm năng (thực tế với cohort hơn 50k mẫu)
- Khôi phục khi lỗi: vùng thất bại chỉ cần chạy lại khoảng 100kb, không phải cả nhiễm sắc thể
- Tối ưu hàng đợi SLURM: các job nhỏ (vùng 100kb) xếp lịch tốt hơn so với job lớn
Ví dụ workflow với GLnexus (theo nhiễm sắc thể cho <10k):
# For each chromosome in parallel:glnexus_cli --config DeepVariant_h37 \ --bed chr1.bed \ sample1.gvcf.gz sample2.gvcf.gz ... sampleN.gvcf.gz \ > cohort_chr1.bcf
# For chr2, chr3, etc. (run in parallel across SLURM cluster)
# Merge all chromosomal BCF filesbcftools concat cohort_chr*.bcf -O z > cohort.vcf.gzVí dụ cho cohort lớn (theo khoảng cho >10k):
# For each 100kb interval in parallel:glnexus_cli --config DeepVariant_h37 \ --bed chr1_region_1.bed \ sample1.gvcf.gz sample2.gvcf.gz ... sample10000.gvcf.gz \ > cohort_chr1_region_1.bcf
# Across all regions simultaneously (SLURM schedules thousands of jobs)
# Final merge (can be done hierarchically: chr1 regions → chr1.bcf, then merge all chr*.bcf)bcftools concat cohort_chr*_region_*.bcf -O z > cohort.vcf.gzVì sao cách này khác biệt về bản chất so với:
- ❌ Gọi biến thể từng mẫu: không thể dùng cho joint genotyping (mất thông tin quần thể)
- ❌ Chạy cả hệ gen cho toàn cohort trong một job: không song song hóa, không khôi phục khi lỗi, nổ bộ nhớ ở quy mô lớn
- Gọi biến thể cohort theo vùng: mở rộng tuyến tính, thất bại một cách "êm ái", tận dụng tối đa song song hóa SLURM
1.3. Lưu trữ và chia sẻ dữ liệu
Về lưu trữ dữ liệu, hãy chuẩn hóa theo hướng chỉ lưu những gì cần thiết:
- Dữ liệu cần được lưu trữ và cấp quyền truy cập phù hợp.
- Tệp BAM/CRAM nên được giữ ở dạng có thể khôi phục về định dạng gốc (FASTQ), vừa tiết kiệm dung lượng vừa dùng làm đầu vào cho nhiều công cụ khai thác thêm thông tin từ dữ liệu.
- Hail MatrixTable, VDS, PLINK và BGEN là dữ liệu đã xử lý, chất lượng cao, sẵn sàng cho phân tích.
- Người dùng không cần nạp lại dữ liệu để lặp lại bước tiền xử lý và kiểm soát chất lượng.
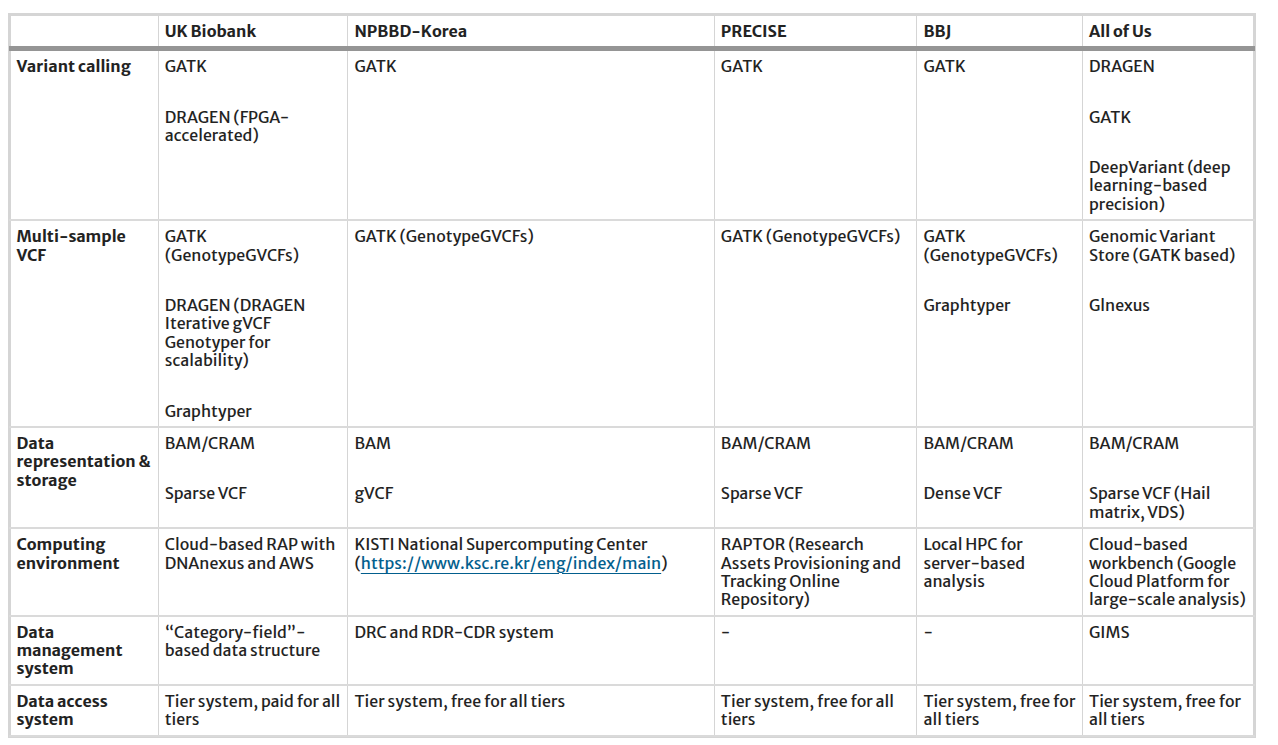
Bảng 1: Các pipeline và công cụ bioinformatics được sử dụng trong nguồn tài nguyên hệ gen của ngân hàng sinh học quốc gia
Tham khảo: https://link.springer.com/article/10.1186/s44342-025-00040-9
Đừng chỉ lưu trữ dữ liệu thô; hãy thiết kế các tầng lưu trữ phục vụ phân tích về sau ngay từ đầu.
Lưu trữ ba tầng:
| Tầng | Định dạng | Mục đích | Dung lượng (10k mẫu) |
|---|---|---|---|
| Thô | gVCF | Dữ liệu gốc, bất biến, lưu trữ lâu dài | 2-3 TB |
| Đã xử lý | VCF cohort | Chuẩn QC, đã joint-called, có phiên bản | 50-100 GB |
| Phân tích | PLINK, BGEN, VDS | Sẵn sàng phân tích, có index, nén | 30-50 GB |
Bảng 2: Kiến trúc lưu trữ ba tầng cho dữ liệu dự án hệ gen
Các định dạng phân tích phục vụ những mục đích khác nhau:
- PLINK: GWAS, phân tích liên kết, PCA (tiêu chuẩn thực tế trong di truyền học)
- BGEN: định dạng nhị phân gọn nhẹ, rất tốt cho nghiên cứu quần thể quy mô lớn
- VDS (Hail): định dạng cột, tốt nhất cho phân tích Hail và pipeline học máy
1.4. Quản trị liên kết và hợp tác đa tổ chức
Hầu hết các dự án hệ gen quốc gia đều có sự tham gia của nhiều bệnh viện, trường đại học và trung tâm nghiên cứu cùng đóng góp mẫu.
Mô hình liên kết:
- Mỗi tổ chức đóng góp mẫu một cách độc lập
- Joint genotyping tập trung đảm bảo tính nhất quán: tất cả mẫu được gọi cùng nhau, không gọi riêng theo tổ chức
- Hạ tầng chia sẻ: nhiều cụm SLURM và lưu trữ S3, với một nền tảng phân tích dữ liệu tập trung
Kiến trúc bảo vệ quyền riêng tư:
- Dữ liệu thô: truy cập hạn chế (chỉ tổ chức đã đóng góp dữ liệu)
- Dữ liệu cohort đã QC: nhà nghiên cứu của tổ chức + ban lãnh đạo dự án
- Thống kê tổng hợp (tần số allele, chỉ số QC): chia sẻ công khai (không có dữ liệu cấp cá nhân)
- Compute-to-data: phân tích chạy trên cụm bảo mật; chỉ xuất kết quả, không xuất dữ liệu thô
Kiểm soát truy cập theo vai trò:
Dữ liệu gVCF thô ├─ Đối tượng truy cập: tổ chức gốc + bộ phận quản lý dữ liệu └─ Quyền: chỉ đọc, có ghi audit log
VCF cohort (đã QC) ├─ Đối tượng truy cập: nhà nghiên cứu của dự án └─ Quyền: phân tích khi có phê duyệt đạo đức
Tần số allele công khai ├─ Đối tượng truy cập: công chúng └─ Tải xuống từ websiteNguyên tắc thiết kế này cho phép các quốc gia hợp tác giữa nhiều tổ chức trong khi vẫn duy trì quản trị dữ liệu nghiêm ngặt và bảo vệ quyền riêng tư của người tham gia.
2. Hạ tầng & lộ trình triển khai
Xây dựng một dự án hệ gen quốc gia đòi hỏi phải sắp xếp các giai đoạn một cách cẩn thận. Phần này trình bày cả yêu cầu hạ tầng lẫn lộ trình triển khai thực tế.
2.1. Tổng quan yêu cầu hạ tầng
Stack hạ tầng của một dự án hệ gen quốc gia gồm ba tầng lõi:
| Tầng | Thành phần | Công nghệ | Mục đích |
|---|---|---|---|
| Tính toán | Cụm HPC | SLURM + node tính toán | Gọi biến thể, joint genotyping, phân tích |
| Lưu trữ | Lưu trữ đối tượng | Tương thích S3 (tại chỗ) | gVCF, VCF, định dạng phân tích |
| Phân tích | Nền tảng dữ liệu | Hail, Python, Spark | Thống kê quần thể, GWAS, QC |
Bảng 3: Các tầng hạ tầng lõi cho dự án hệ gen quốc gia
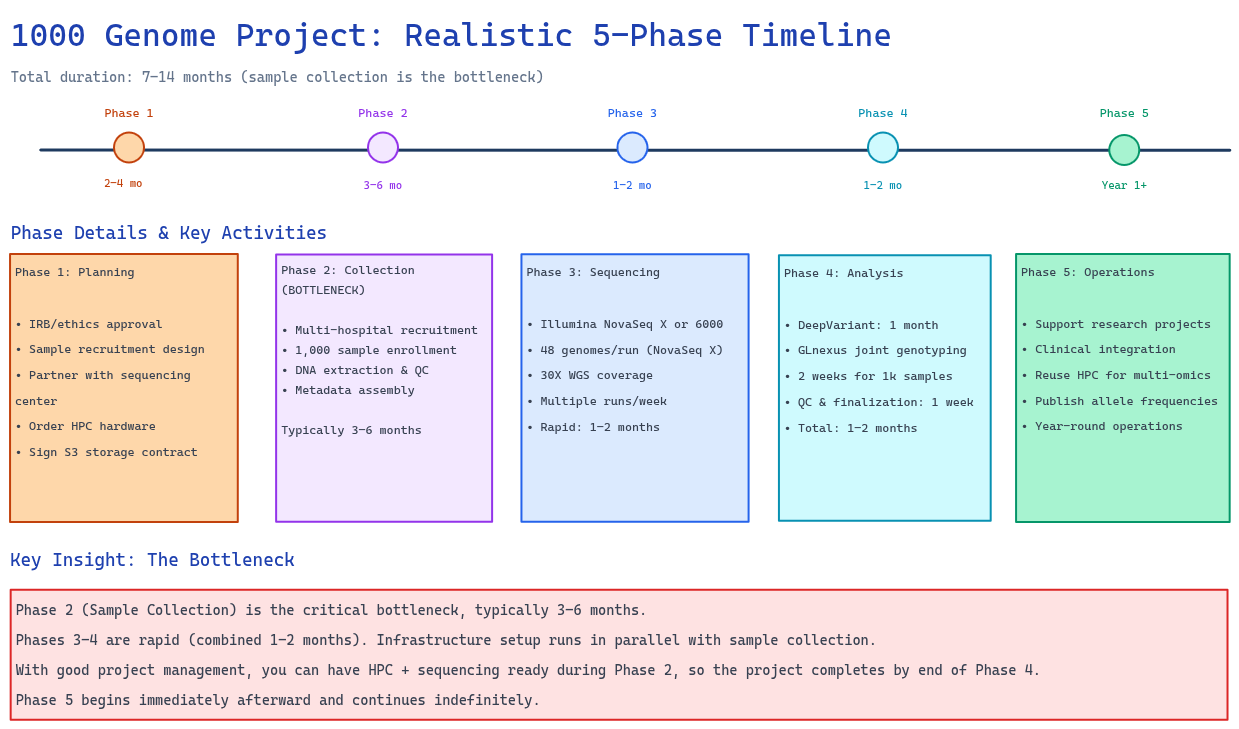
Hình 3: Lộ trình triển khai thực tế 6–12 tháng với cả năm giai đoạn. Điểm mấu chốt: giai đoạn 2 (thu thập mẫu) là nút thắt cổ chai (3–6 tháng). Giai đoạn 3 (giải trình tự) và giai đoạn 4 (gọi biến thể + QC) diễn ra nhanh (1–2 tháng mỗi giai đoạn). Việc thiết lập hạ tầng chạy song song với thu thập mẫu.
2.2. Giai đoạn 1: Lập kế hoạch & đạo đức (2–4 tháng)
Mục tiêu:
- Đảm bảo phê duyệt của tổ chức (IRB/đạo đức)
- Thiết kế chiến lược tuyển chọn mẫu
- Thiết lập quan hệ đối tác giải trình tự
- Bắt đầu mua sắm hạ tầng
Tiến độ:
- Phê duyệt IRB/đạo đức: 1–2 tháng
- Thiết kế tuyển chọn mẫu & thỏa thuận đối tác: 1–2 tháng
- Song song: đặt mua phần cứng HPC và thiết lập hợp đồng đối tác S3
Kết quả cuối giai đoạn 1:
- Đã có phê duyệt IRB/đạo đức
- Chiến lược tuyển chọn được chốt
- Năng lực giải trình tự được xác nhận (hợp tác với trung tâm giải trình tự hoặc tự thực hiện)
- Đã đặt mua phần cứng HPC (giao hàng 4–8 tuần)
- Đã ký hợp đồng đối tác S3
2.3. Giai đoạn 2: Thu thập mẫu (3–6 tháng)
Mục tiêu:
- Tuyển chọn và đưa vào 1.000 người tham gia
- Thực hiện tách chiết DNA
- Thiết lập các quy trình quản trị dữ liệu
Tiến độ:
- Tuyển chọn tại nhiều bệnh viện: 3–6 tháng (thường là giai đoạn chậm nhất)
- Tách chiết DNA & kiểm soát chất lượng: song song với tuyển chọn
- Tập hợp metadata cohort: đồng thời
Thách thức chính: thu thập mẫu thường là nút thắt cổ chai. Cần dự trù cho:
- Điều phối bệnh viện trên nhiều địa điểm
- Tuân thủ và lịch trình của người tham gia
- Kiểm soát chất lượng DNA (đảm bảo hơn 95% vượt ngưỡng)
- Chuẩn hóa metadata
Kết quả cuối giai đoạn 2:
- 1.000 mẫu được thu thập, tách chiết và QC
- Cơ sở dữ liệu metadata được thiết lập
- Mẫu sẵn sàng cho giải trình tự
2.4. Giai đoạn 3: Giải trình tự (1–2 tháng)
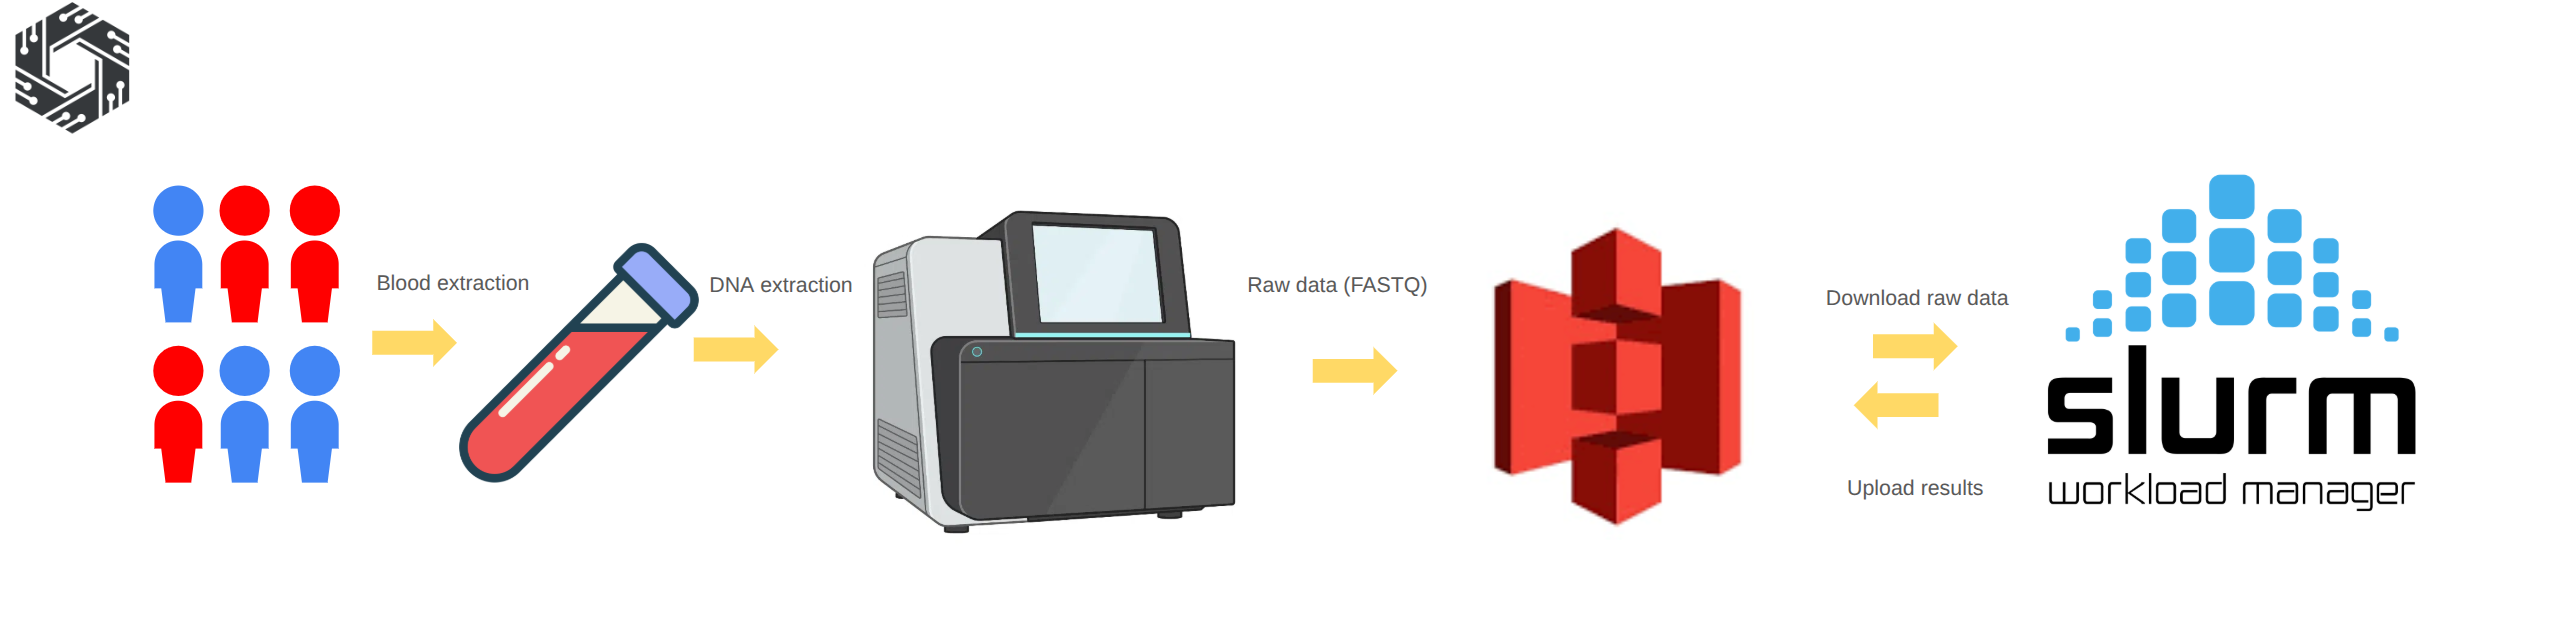
Hình 4: Quy trình giải trình tự: mẫu máu được thu từ người tham gia và DNA hệ gen được tách chiết bằng các quy trình phòng xét nghiệm chuẩn. DNA sau đó được chuẩn bị cho giải trình tự và xử lý trên các nền tảng thông lượng cao, tạo ra dữ liệu giải trình tự thô ở định dạng FASTQ. Dữ liệu thô được tải lên lưu trữ đối tượng như Amazon S3 hoặc một đối tác tương thích S3. Hệ thống HPC tải dữ liệu từ S3, thực hiện alignment và gọi biến thể, rồi tải kết quả đã xử lý trở lại S3 để lưu trữ dài hạn và phân tích quần thể về sau.
Mục tiêu:
- Giải trình tự toàn bộ 1.000 mẫu ở độ sâu WGS 30X
- Chuyển tệp FASTQ đến cụm HPC
- Bắt đầu gọi biến thể ngay khi dữ liệu về
Thiết lập cụm HPC (song song với giải trình tự):
Tham khảo: playbook Ansible omicslab-hpc
Cụm tối thiểu khả dụng:
- 1 head node (Slurm controller, node đăng nhập)
- 4-8 node tính toán (2 socket, 32-64 CPU mỗi node)
- 100TB SSD nội bộ cho không gian scratch
- Kết nối mạng 1Gbps
Nâng cấp tùy chọn (để gọi biến thể nhanh hơn):
- 2 node GPU với NVIDIA GPU (tăng tốc DeepVariant)
- Giảm thời gian gọi biến thể mỗi mẫu từ 4-6 giờ (chỉ CPU) xuống 1-2 giờ
- Tối ưu tùy chọn (không bắt buộc với mục tiêu 1k mẫu)
Dùng Ansible để tự động hóa hạ tầng:
# Deploy entire SLURM cluster from scratchansible-playbook -i inventory.ini cluster_slurm.yml
# Validates:- 1. All nodes can submit/run jobs- 2. Job scheduling policies working- 3. Network connectivity stableHợp tác lưu trữ S3 trong nước (đã khởi động)
- Lưu trữ theo chuẩn công nghiệp: lưu trữ đối tượng như Amazon S3, Google Cloud Storage, Azure Blob Storage hoặc nhà cung cấp tương thích S3 nội địa được dùng rộng rãi khắp các ngành, đảm bảo khả năng mở rộng, tương thích và bền vững lâu dài ngoài phạm vi bioinformatics.
- Tính sẵn sàng cao đòi hỏi chuyên môn riêng: các dự án genomics quần thể tạo ra dữ liệu từ hàng trăm TB đến PB. Duy trì tính sẵn sàng cao, thông lượng, sao lưu và bảo mật cần một đội hạ tầng chuyên trách, làm tăng độ phức tạp vận hành.
- Giảm chi phí và độ phức tạp vận hành: hợp tác với nhà cung cấp S3 chuyển việc quản lý hạ tầng sang những đội ngũ giàu kinh nghiệm, giảm chi phí bảo trì và cho phép dự án tập trung vào phân tích và kết quả khoa học.
Dùng nhà cung cấp S3 bên ngoài là một hướng khả thi
Các lựa chọn:
- Nhà cung cấp cloud thương mại trong nước (đảm bảo lưu trú dữ liệu tại địa phương)
- Hạ tầng do nhà nước hậu thuẫn (nếu có ở quốc gia của bạn)
- Hợp tác cloud học thuật (trung tâm dữ liệu của trường đại học)
Yêu cầu chính:
- Dữ liệu không bao giờ rời khỏi đất nước (yêu cầu về chủ quyền)
- Các node SLURM tại chỗ có truy cập mạng trực tiếp (độ trễ thấp)
- Hợp đồng cam kết 5-10 năm
- Có thể mở rộng từ dự án này, đồng thời mở ra khả năng tăng dung lượng lưu trữ
Kiểm soát chất lượng dữ liệu thô
Sau khi giải trình tự, dữ liệu FASTQ thô cần được kiểm soát chất lượng để đảm bảo phù hợp cho phân tích về sau. Bước này thường bao gồm kiểm tra điểm chất lượng giải trình tự, phân bố độ dài read, hàm lượng GC, nhiễm adapter và mức độ trùng lặp bằng các công cụ như FastQC và MultiQC.
Những mẫu không đạt ngưỡng chất lượng có thể cần giải trình tự lại hoặc tiền xử lý thêm như cắt adapter và lọc. Thực hiện kiểm soát chất lượng ở bước này đảm bảo dữ liệu đáng tin cậy và sẵn sàng cho các bước alignment và gọi biến thể tiếp theo.
Kết quả cuối giai đoạn 3:
- Toàn bộ 1.000 mẫu đã được giải trình tự (tệp FASTQ đã bàn giao)
- Tệp FASTQ đã chuyển lên cụm HPC và lưu trữ trong S3
- Sẵn sàng gọi biến thể ở giai đoạn 4
2.5. Giai đoạn 4: Gọi biến thể + QC (1–2 tháng)
Mục tiêu:
- Gọi biến thể trên toàn bộ 1.000 mẫu bằng DeepVariant
- Thực hiện joint genotyping với GLnexus
- Hoàn tất QC cohort và chốt dữ liệu
Pipeline gọi biến thể (song song với giải trình tự):
Triển khai nf-germline-short-read-variant-calling
Dùng DeepVariant để gọi biến thể với độ chính xác cao:
- Gọi biến thể từng mẫu: 4-6 giờ (chỉ CPU) 1-2 giờ (có tăng tốc GPU)
- Song song hóa theo nhiễm sắc thể: 22 job đồng thời
Tiến độ cho 1.000 mẫu:
- Với 4-8 node CPU: khoảng 1-2 tuần để tạo toàn bộ gVCF
- Với 2 node GPU tùy chọn: khoảng 1 tuần để tạo toàn bộ gVCF
Joint genotyping:
GLnexus thực hiện joint genotyping bằng cách:
- Kết hợp toàn bộ 1.000 gVCF thành một VCF cohort
- Xử lý theo nhiễm sắc thể với 22 job song song
- Hoàn thành trong 2–5 ngày (tùy mật độ biến thể)
- Tạo ra một VCF cohort duy nhất chứa mọi biến thể
QC + tập hợp cohort:
Sau joint genotyping, thực hiện các kiểm tra chất lượng:
- QC cấp mẫu: nhiễm chéo, độ sâu, quan hệ huyết thống
- QC cấp biến thể: phân bố tần số allele, cân bằng Hardy-Weinberg
- Phân tích cấu trúc quần thể: PCA
- Chuẩn bị VCF cohort cho bản phát hành cuối
Tiến độ: khoảng 1 tuần cho QC và chốt dữ liệu
Tổng thời gian giai đoạn 4: 1–2 tháng
- Gọi biến thể: 1–2 tuần
- Joint genotyping: 2–5 ngày
- QC & chốt dữ liệu: 1 tuần
- Cộng lại: 1–2 tháng
Kết quả cuối giai đoạn 4:
- Toàn bộ 1.000 mẫu đã qua gọi biến thể
- 1.000 tệp gVCF chất lượng cao được tạo
- VCF cohort đã chốt (joint genotyping hoàn tất)
- Đạt QC cấp quần thể
- Sẵn sàng cho phân tích và nghiên cứu
2.6. Giai đoạn 5: Vận hành & hỗ trợ nghiên cứu (Năm 1+)
Mục tiêu:
- Thiết lập vận hành ổn định
- Cho phép nghiên cứu cấp quần thể
- Hỗ trợ chẩn đoán lâm sàng và y học chính xác
Độ trưởng thành của hạ tầng:
- Duy trì 4-8 node tính toán (hạ tầng lõi)
- Tùy chọn 2 node GPU để tăng tốc gọi biến thể
Cơ hội tận dụng lại: Hạ tầng này được xây cho phân tích 1k hệ gen, nhưng có thể tái sử dụng cho:
- Xử lý đa omics (proteomics, metabolomics, RNA-seq)
- Pipeline giải nghĩa bệnh hiếm
- Workflow genomics lâm sàng
- Nền tảng nghiên cứu bioinformatics nâng cao
Năng lực ở quy mô 1k mẫu:
- Phân tích GWAS: vài phút đến vài giờ
- Pipeline chú giải biến thể: vài giờ
- Thống kê quần thể: vài phút
- Năng lực dư thừa: sẵn sàng cho nghiên cứu khác
Nền tảng phân tích: Hail MatrixTable (cho phân tích quần thể):
- Toàn bộ 1.000 mẫu + biến thể trong một đối tượng phân tích duy nhất
- QC từng mẫu: tính tổ tiên, quan hệ huyết thống, thống kê riêng của mẫu
- QC từng biến thể: phân bố tần số allele, cấu trúc quần thể
- Truy vấn nhanh: lọc theo tần số allele, quần thể, kiểu hình
Hỗ trợ nghiên cứu:
- Xuất sang PLINK cho GWAS
- Xuất sang BGEN cho nghiên cứu imputation
- Phân tích trực tiếp qua Hail Batch cho tính toán phân tán
Truy cập dữ liệu & quản trị: Lưu trữ S3 trong nước (dài hạn):
- Hợp đồng đã thiết lập: cam kết 5-10 năm
- Lưu trú dữ liệu: mọi dữ liệu ở lại trong nước
- Mô hình trả phí theo nhu cầu: khoảng 0,02-0,05 USD/GB/tháng
- Truy cập SLURM trực tiếp: truy vấn độ trễ thấp
Chính sách truy cập dữ liệu:
- Nhà nghiên cứu truy cập dữ liệu qua nền tảng phân tích được kiểm soát
- Bắt buộc đào tạo trước khi truy cập dữ liệu
- Có audit trail cho mọi lần truy cập dữ liệu
- Không tải xuống dữ liệu thô (chỉ thống kê tổng hợp)
Kết quả cuối giai đoạn 5:
- Vận hành ở mức production được thiết lập
- Các dự án nghiên cứu được hỗ trợ
- Con đường tích hợp lâm sàng rõ ràng
- Hạ tầng có thể tái sử dụng cho các dự án tương lai
2.7. Tóm tắt tiến độ tổng thể
Tổng thời gian dự án: 6–12 tháng (khoảng thực tế có tính đến nút thắt thu thập mẫu)
| Giai đoạn | Hoạt động | Thời lượng | Nút thắt |
|---|---|---|---|
| Giai đoạn 1 | Lập kế hoạch & đạo đức | 2–4 tháng | Phê duyệt IRB |
| Giai đoạn 2 | Thu thập mẫu | 3–6 tháng | Tuyển chọn tại nhiều bệnh viện |
| Giai đoạn 3 | Giải trình tự | 1–2 tháng | Tốc độ bàn giao mẫu |
| Giai đoạn 4 | Gọi biến thể + QC | 1–2 tháng | Thông lượng tính toán |
| Giai đoạn 5 | Vận hành & hỗ trợ nghiên cứu | Năm 1+ | Liên tục |
Bảng 4: Tóm tắt tiến độ dự án với thời lượng từng giai đoạn và nút thắt
Điểm mấu chốt: đường găng là giai đoạn 2 (thu thập mẫu), thường mất 3-6 tháng. Giai đoạn 3 và 4 diễn ra nhanh (1–2 tháng mỗi giai đoạn). Hạ tầng (lập kế hoạch ở giai đoạn 1 và triển khai ở giai đoạn 3) chạy song song với thu thập mẫu.
2.8. Các yếu tố thành công then chốt
Kỹ thuật:
- Gọi biến thể vững chắc (đã benchmark và kiểm chứng)
- Joint genotyping đáng tin cậy (được kiểm thử kỹ lưỡng)
- QC tự động (bắt lỗi trước khi công bố)
- Tích hợp CI/CD (đảm bảo khả năng tái lập)
Tổ chức:
- Đội ngũ chuyên trách (tối thiểu 2-3 nhân sự toàn thời gian, ổn định)
- Quản trị rõ ràng (ai quyết định quyền truy cập dữ liệu, thay đổi pipeline)
- Sự đồng thuận của tổ chức (hệ thống bệnh viện, cam kết của trường đại học)
- Nguồn tài trợ bền vững (cam kết nhiều năm, không phụ thuộc từng khoản grant)
Chiến lược:
- Thu hút cộng đồng quần thể (minh bạch về việc sử dụng dữ liệu)
- Quan hệ đối tác nghiên cứu (hợp tác sớm với các trường đại học)
- Tích hợp lâm sàng (chứng minh lợi ích trực tiếp cho bệnh nhân)
- Tiêu chuẩn quốc tế (tuân theo 1000 Genomes, GA4GH, v.v.)
2.9. Giảm thiểu rủi ro & phương án dự phòng
Rủi ro: lỗi pipeline gây sai sót hệ thống trên 1k mẫu
- Giảm thiểu: kiểm thử CI/CD toàn diện; xử lý theo vùng với checkpoint; có thể chạy lại bất kỳ vùng nào
Rủi ro: mất hoặc hỏng dữ liệu
- Giảm thiểu: sao lưu nhiều địa điểm; gVCF được lưu trữ bất biến; quản lý phiên bản cho mọi mã nguồn/cấu hình
Rủi ro: nhân sự chủ chốt rời đi
- Giảm thiểu: tài liệu hóa, runbook, đào tạo; chuyển giao kiến thức; mã nguồn mở (không khóa nhà cung cấp)
Rủi ro: thay đổi quy định ảnh hưởng đến chia sẻ dữ liệu
- Giảm thiểu: privacy-by-design (lưu trữ nội địa, truy cập theo vai trò); biểu mẫu đồng thuận rõ ràng; rà soát pháp lý định kỳ
Rủi ro: gián đoạn tài trợ
- Giảm thiểu: chứng minh giá trị nghiên cứu sớm; công bố kết quả; gắn kết các bên liên quan; tìm kiếm cam kết nhiều năm
Ở Phần 3, chúng ta bắt đầu từ gọi biến thể và joint genotyping, rồi đi sâu vào tầng phân tích cohort bằng Hail và kiến trúc lưu trữ dữ liệu.
Tài liệu tham khảo
Repository của chuỗi bài
- omicslab-hpc — tự động hóa Ansible để dựng cụm SLURM HPC. https://github.com/vieomics/omicslab-hpc
- nf-germline-short-read-variant-calling — pipeline gọi biến thể germline chuẩn hóa từ dữ liệu đọc ngắn. https://github.com/vieomics/nf-germline-short-read-variant-calling
- nf-modules — module và subworkflow Nextflow dùng chung giữa các pipeline trong chuỗi bài. https://github.com/vieomics/nf-modules
- omicslab-kit — các triển khai gkit (GLnexus, DPGT, Spark-on-SLURM, Hail). https://github.com/vieomics/omicslab-kit
Nguồn & đọc thêm
- Lee et al. (2025) — bài học từ các dự án ngân hàng sinh học quốc gia sử dụng giải trình tự toàn hệ gen (Genomics & Informatics). https://link.springer.com/article/10.1186/s44342-025-00040-9
- GLnexus — joint genotyping gVCF thành call set cohort hiệu quả. https://github.com/dnanexus-rnd/GLnexus
- DeepVariant — công cụ gọi biến thể dùng học sâu trong các ví dụ pipeline. https://github.com/google/deepvariant
- Nextflow — workflow engine đứng sau các pipeline trong chuỗi bài. https://www.nextflow.io/
- Hail — nền tảng phân tích di truyền quy mô quần thể. https://hail.is/
Đây là Phần 2 của chuỗi bài. Tiếp tục đến Phần 3 để tìm hiểu về phân tích cohort và tổ chức dữ liệu.
Bài viết gần đây
28 tháng 09, 2026
Hướng dẫn xây dựng bộ genome vi khuẩn không cần lập trình



4 tháng 05, 2026
Pipeline phân tích methyl hóa từ dữ liệu đọc ngắn với Nextflow

3 tháng 05, 2026